两份开源 Agent 题库,以及它们对我方优先级排序的交叉验证
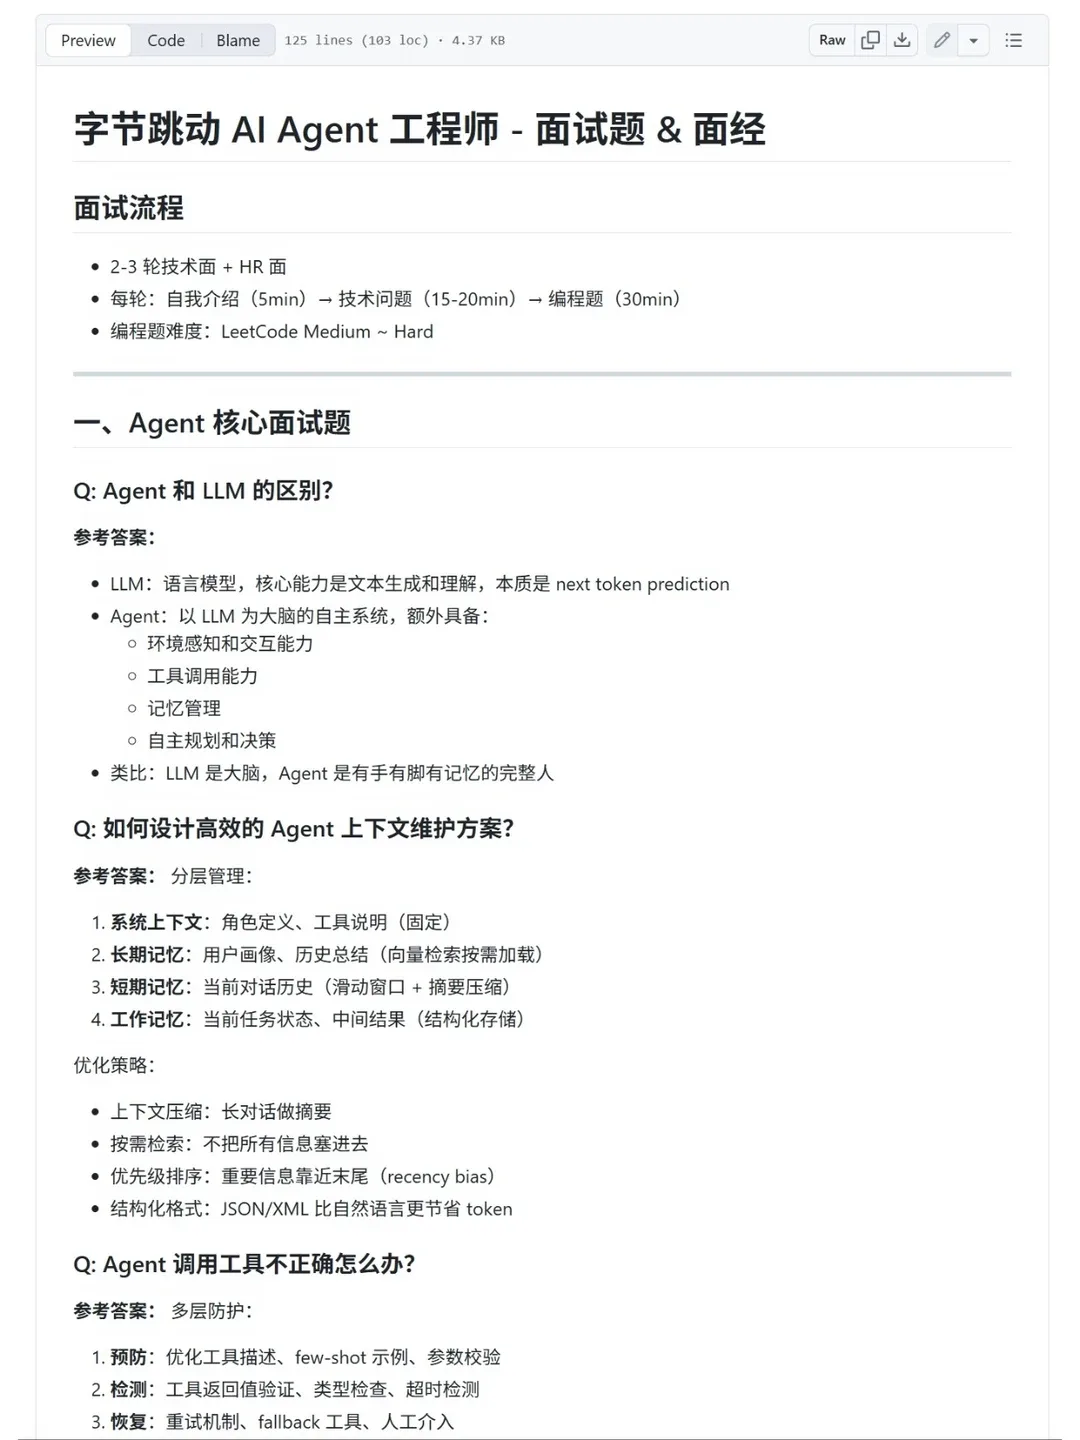
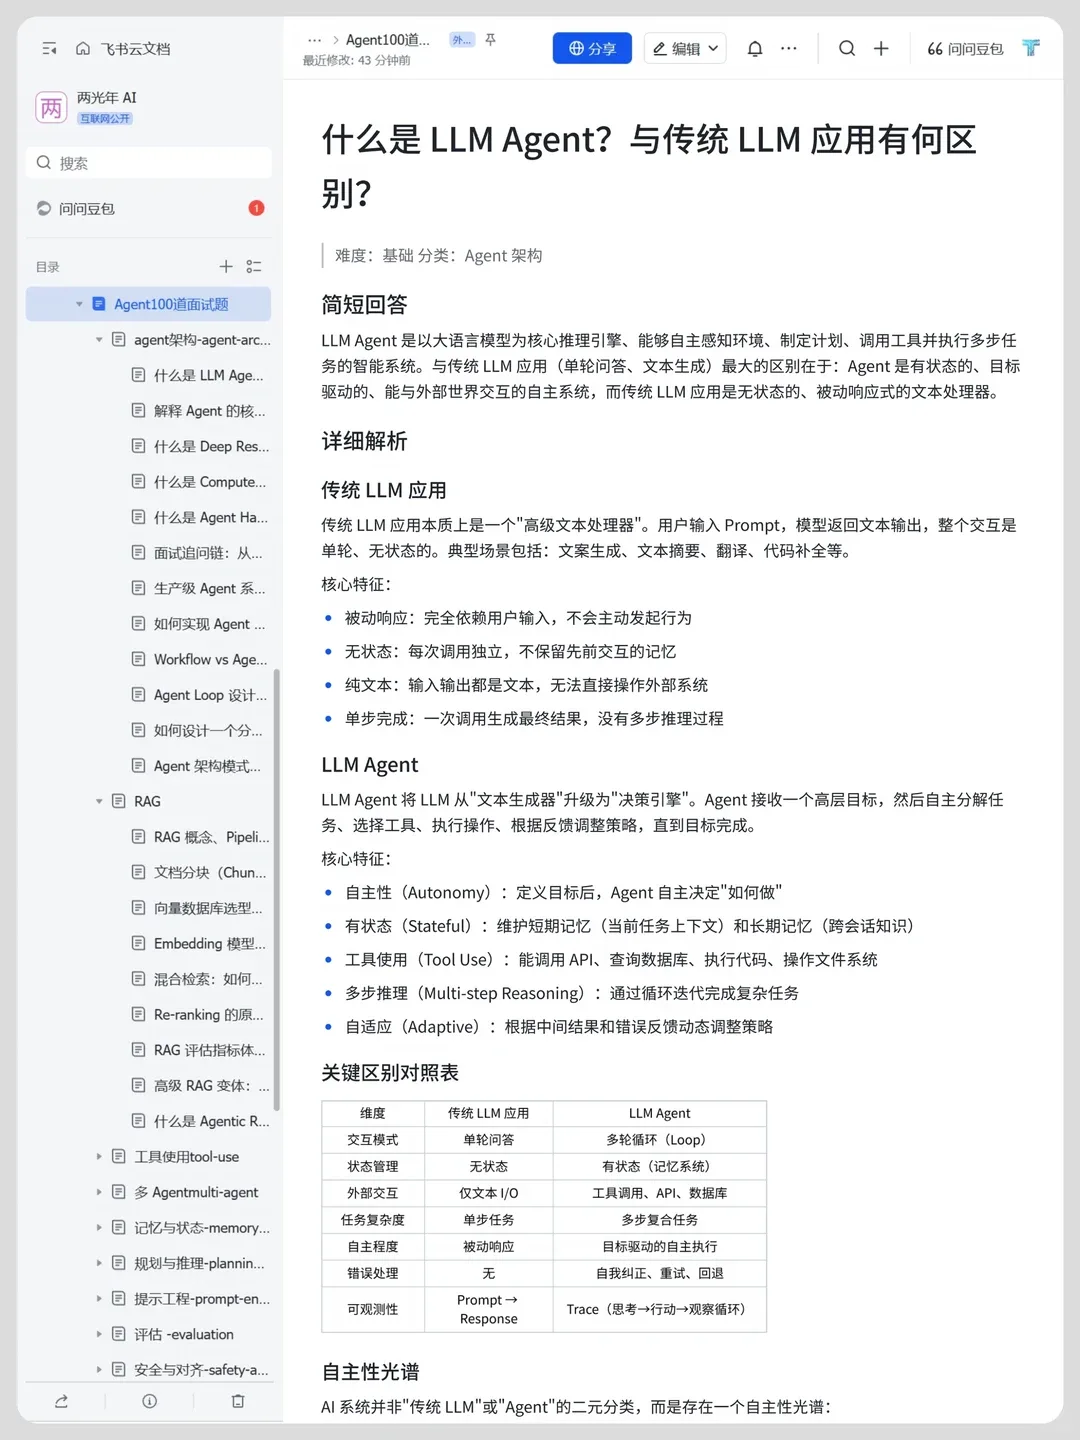
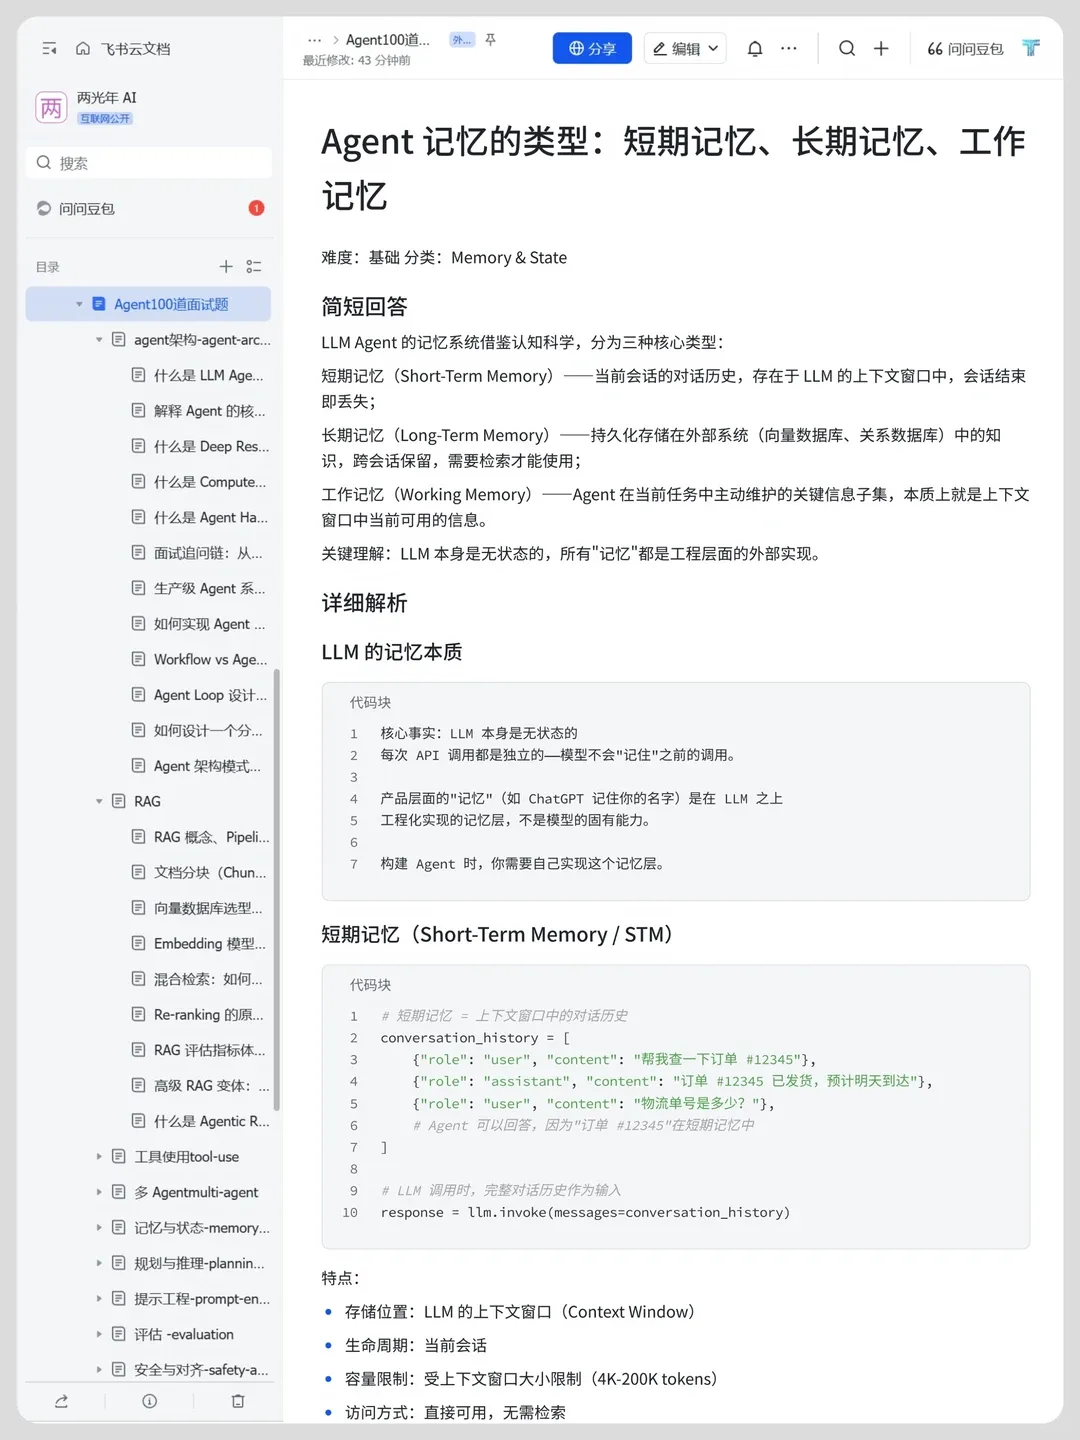
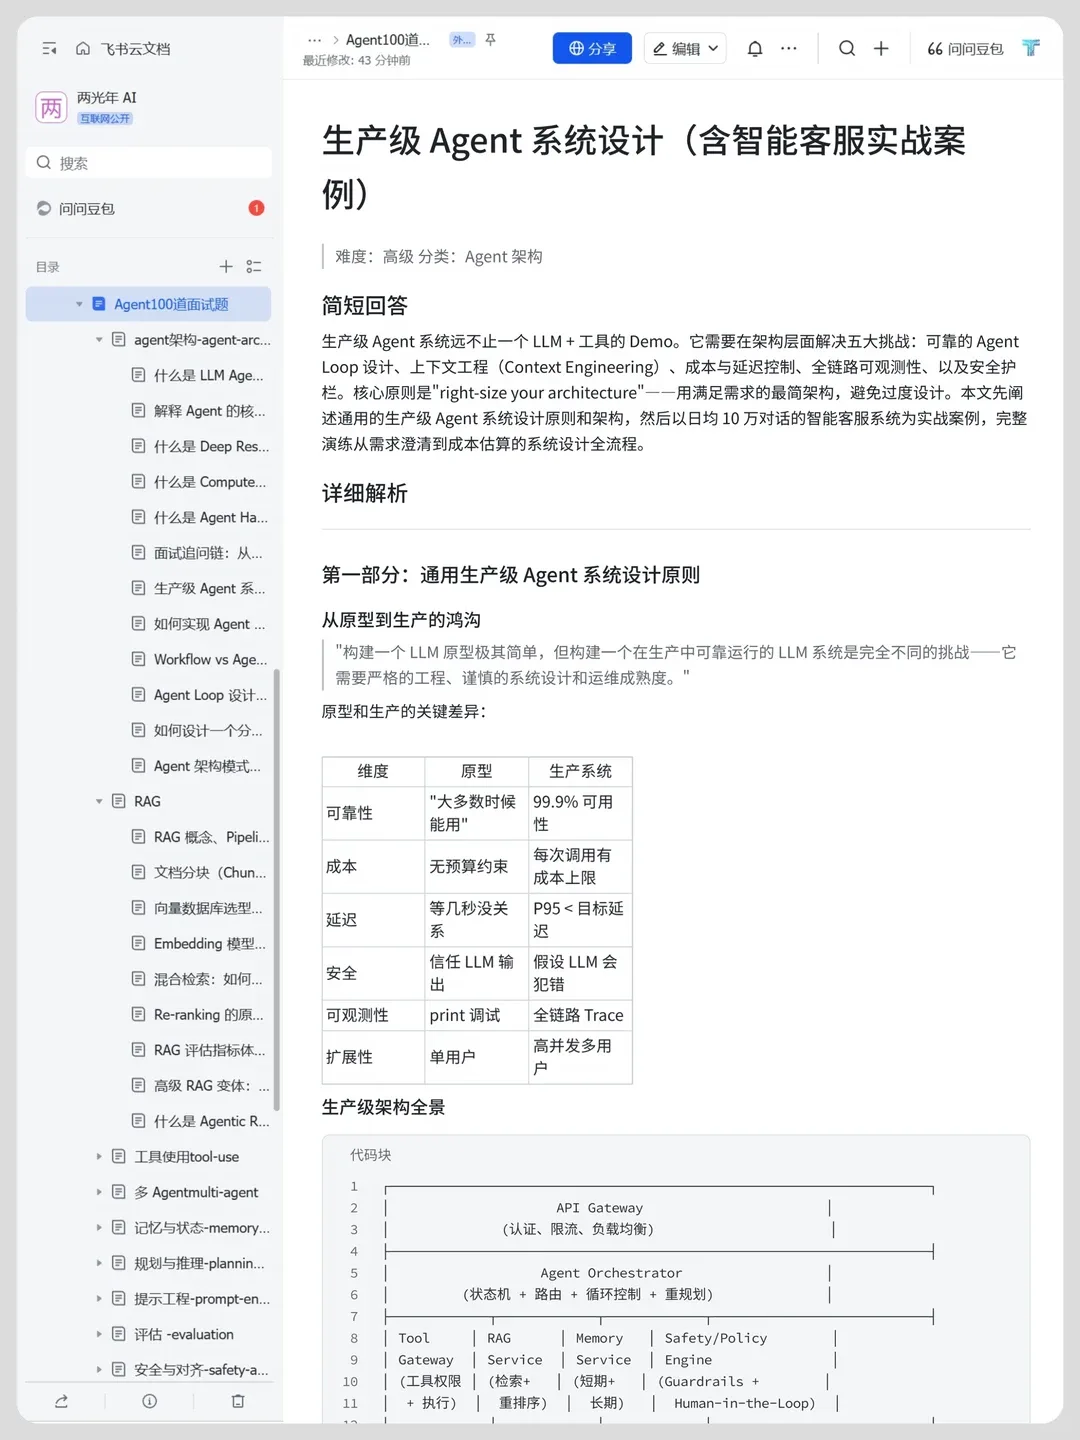
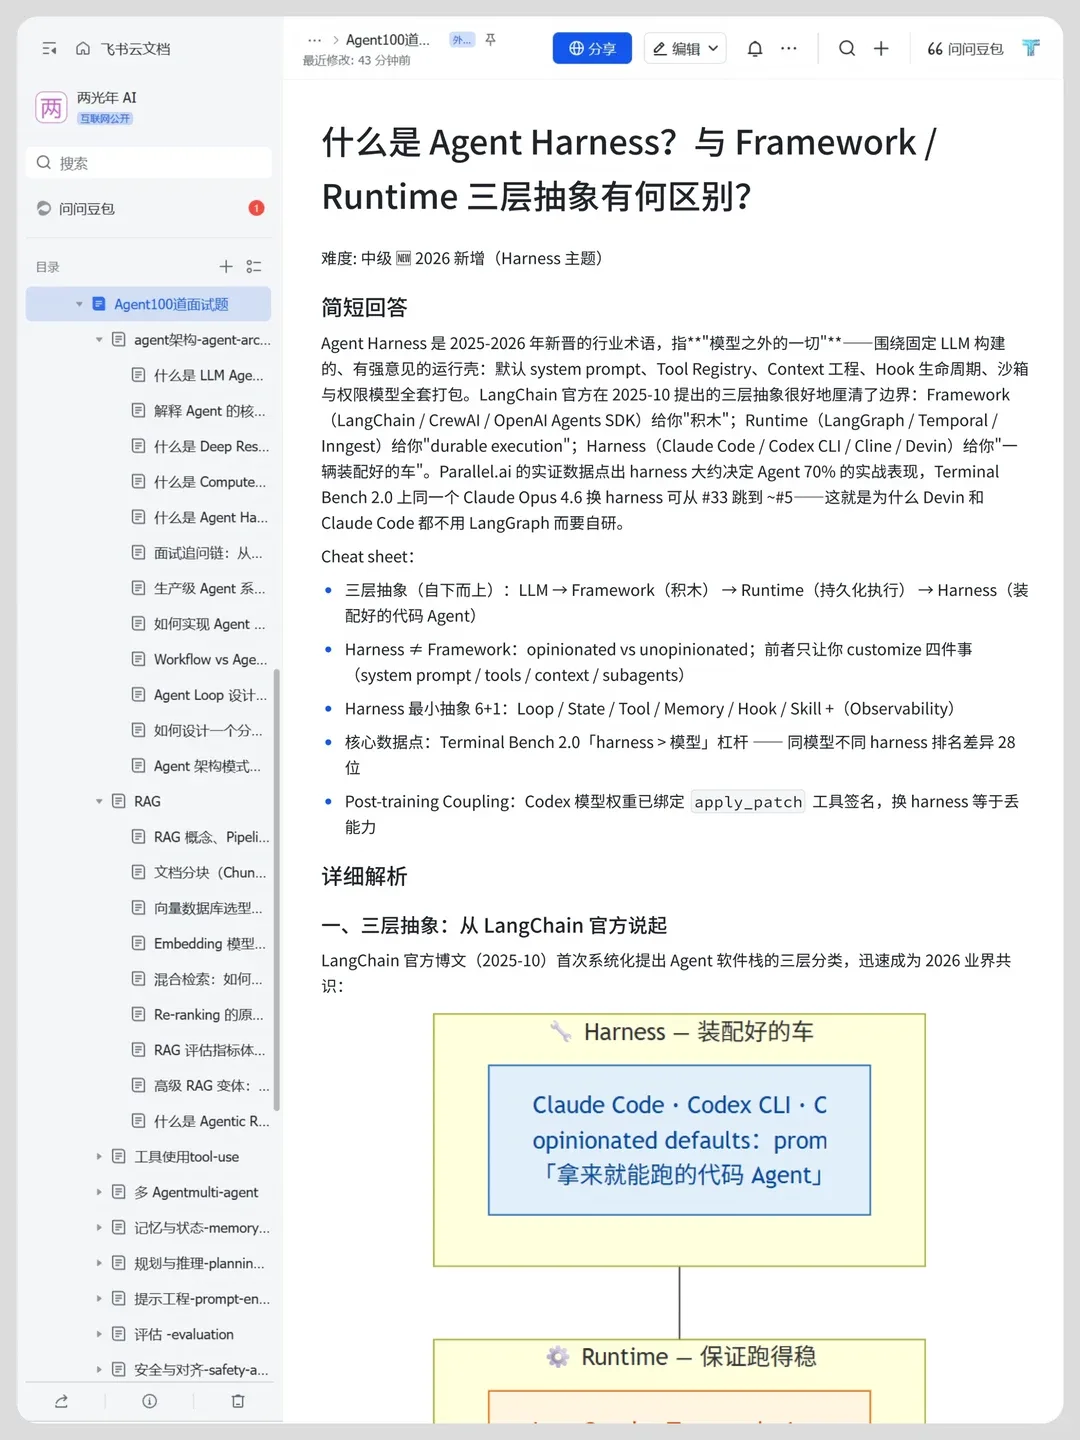
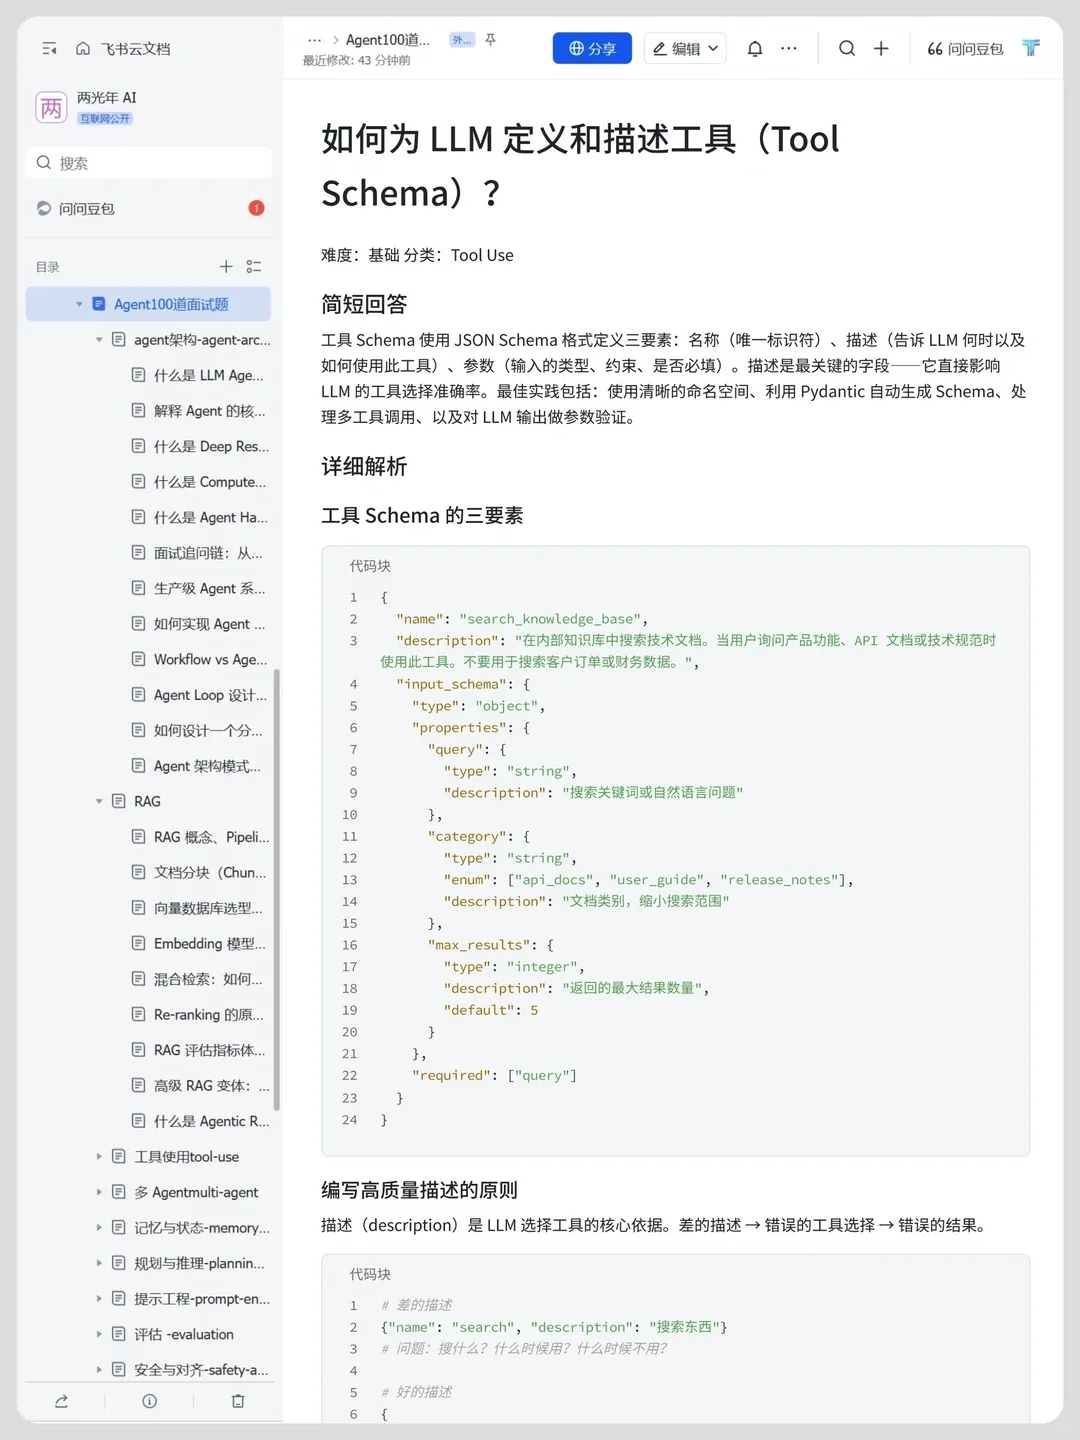
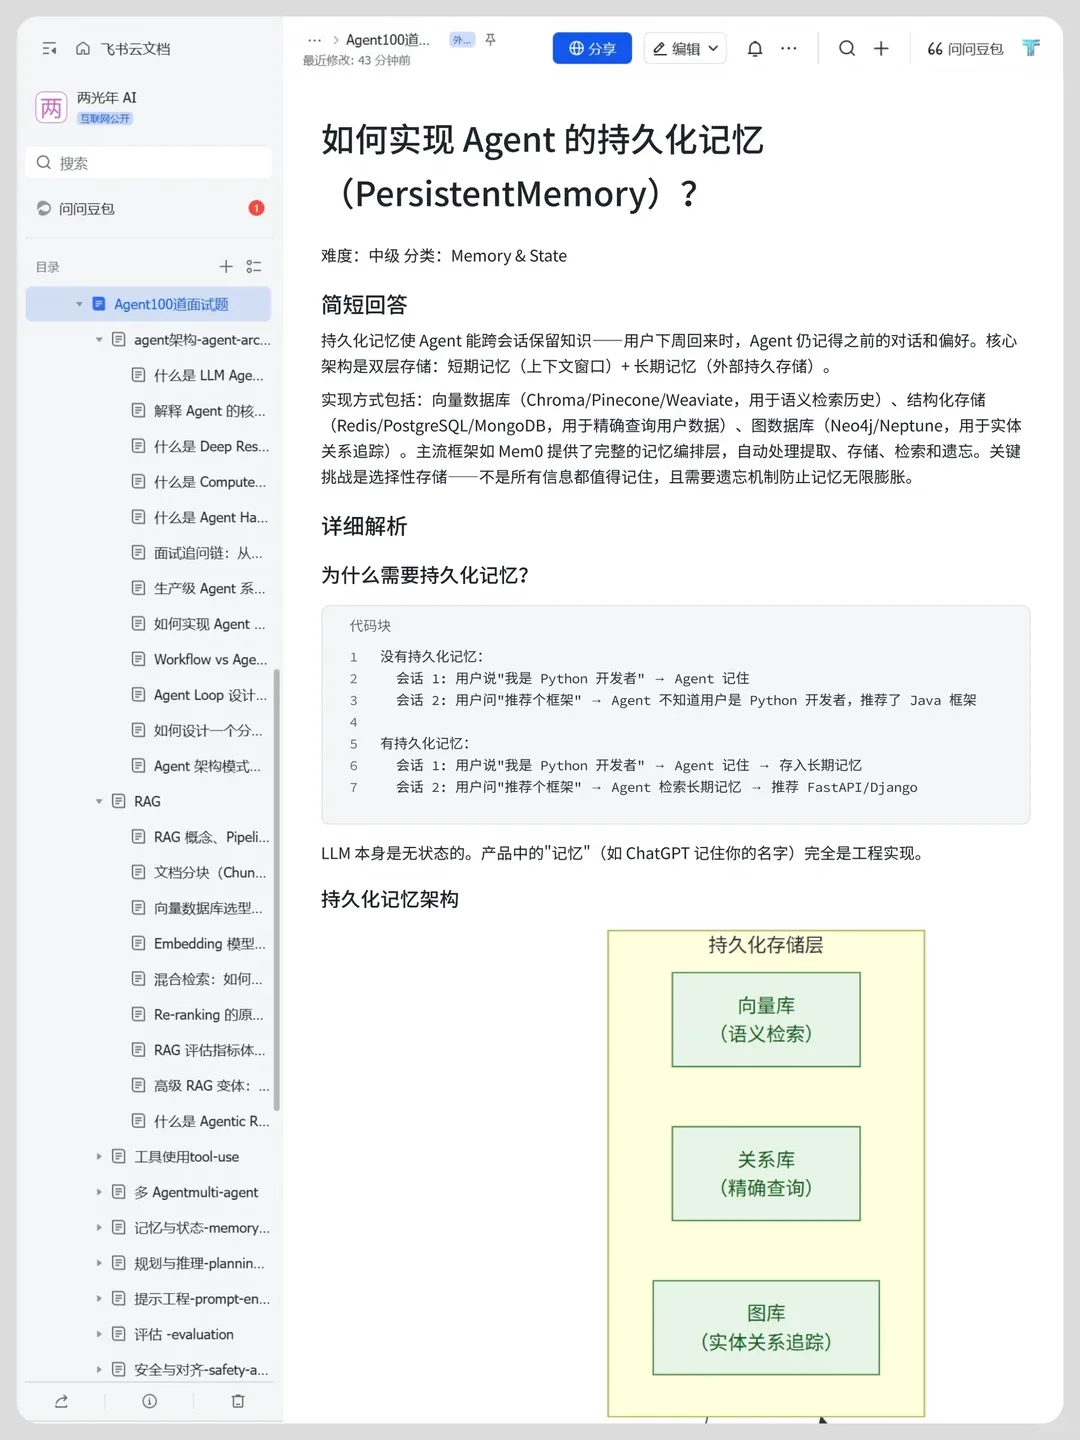
2026-09-23,小红书上有两条帖子在贴仓库截图。一条 34 赞,贴了 16 张,是一个 100 题的 Agent 面试题库,分 11 个模块;另一条 98 赞,贴了 5 张,是一个以「16 周从基础到 Offer」为主线的学习路线仓库。
我把两份截图里的目录结构都拆了一遍。拆完发现一件比资源本身更有意思的事:那个 100 题题库里题量最多的模块是「生产与部署」(13 题),而我从 14 天面经反推出来的清单里,这一项排在 P2。
三个问题因此变得具体:
- 这两份资源的模块划分分别是什么?
- 它和我从面经反推的优先级,哪里一致、哪里不一致?
- 不一致的那一处,谁更可能是对的?
先把边界说清楚。我只读了帖子里的截图,没有逐题读完那 100 题,所以下面所有模块名和题量都来自截图直读,不是仓库当前状态。两个仓库的 star 数、最近更新时间、维护状态我都没有核实,凡是涉及「这个资源有多权威」的判断都属于我的推断。截图里的目录也可能已经过期。
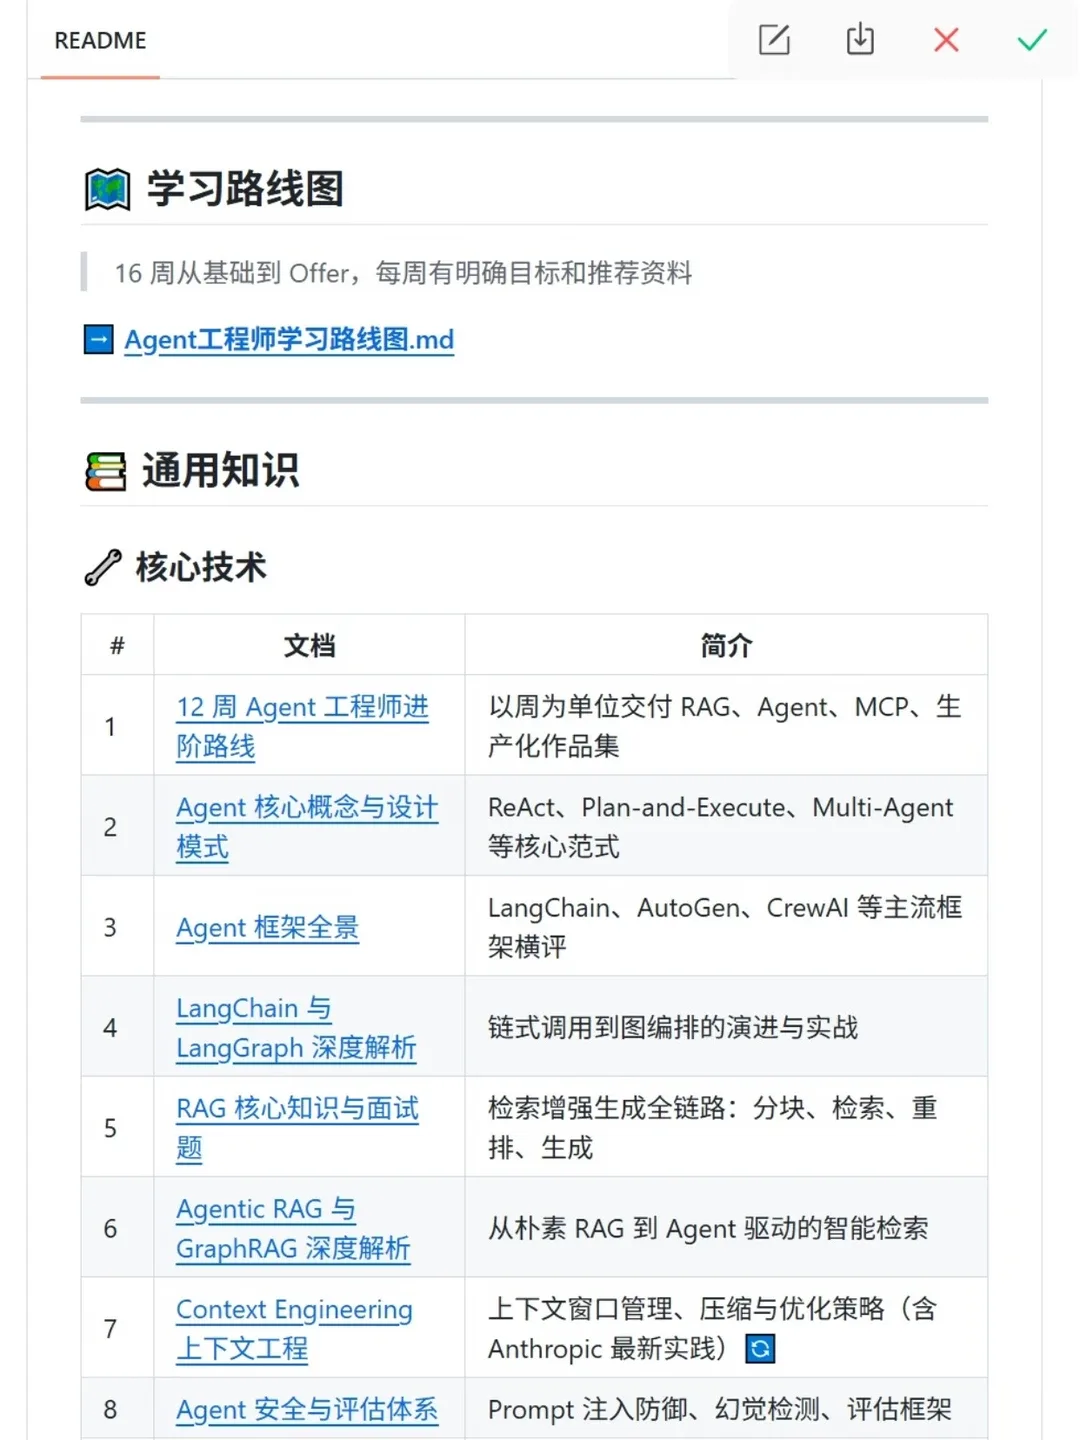
它的 README 本身就是一张路线图,按周交付 RAG、Agent、MCP 与生产化作品集。目录分三块(截图直读):
| 板块 | 覆盖内容 |
|---|---|
| 通用知识 / 核心技术 | 12 周进阶路线;Agent 核心概念与设计模式(ReAct / Plan-and-Execute / Multi-Agent);框架全景(LangChain / AutoGen / CrewAI 横评);LangChain 与 LangGraph 深度解析;RAG 核心知识与面试题;Agentic RAG 与 GraphRAG;Context Engineering 上下文工程(含 Anthropic 实践);Agent 安全与评估体系 |
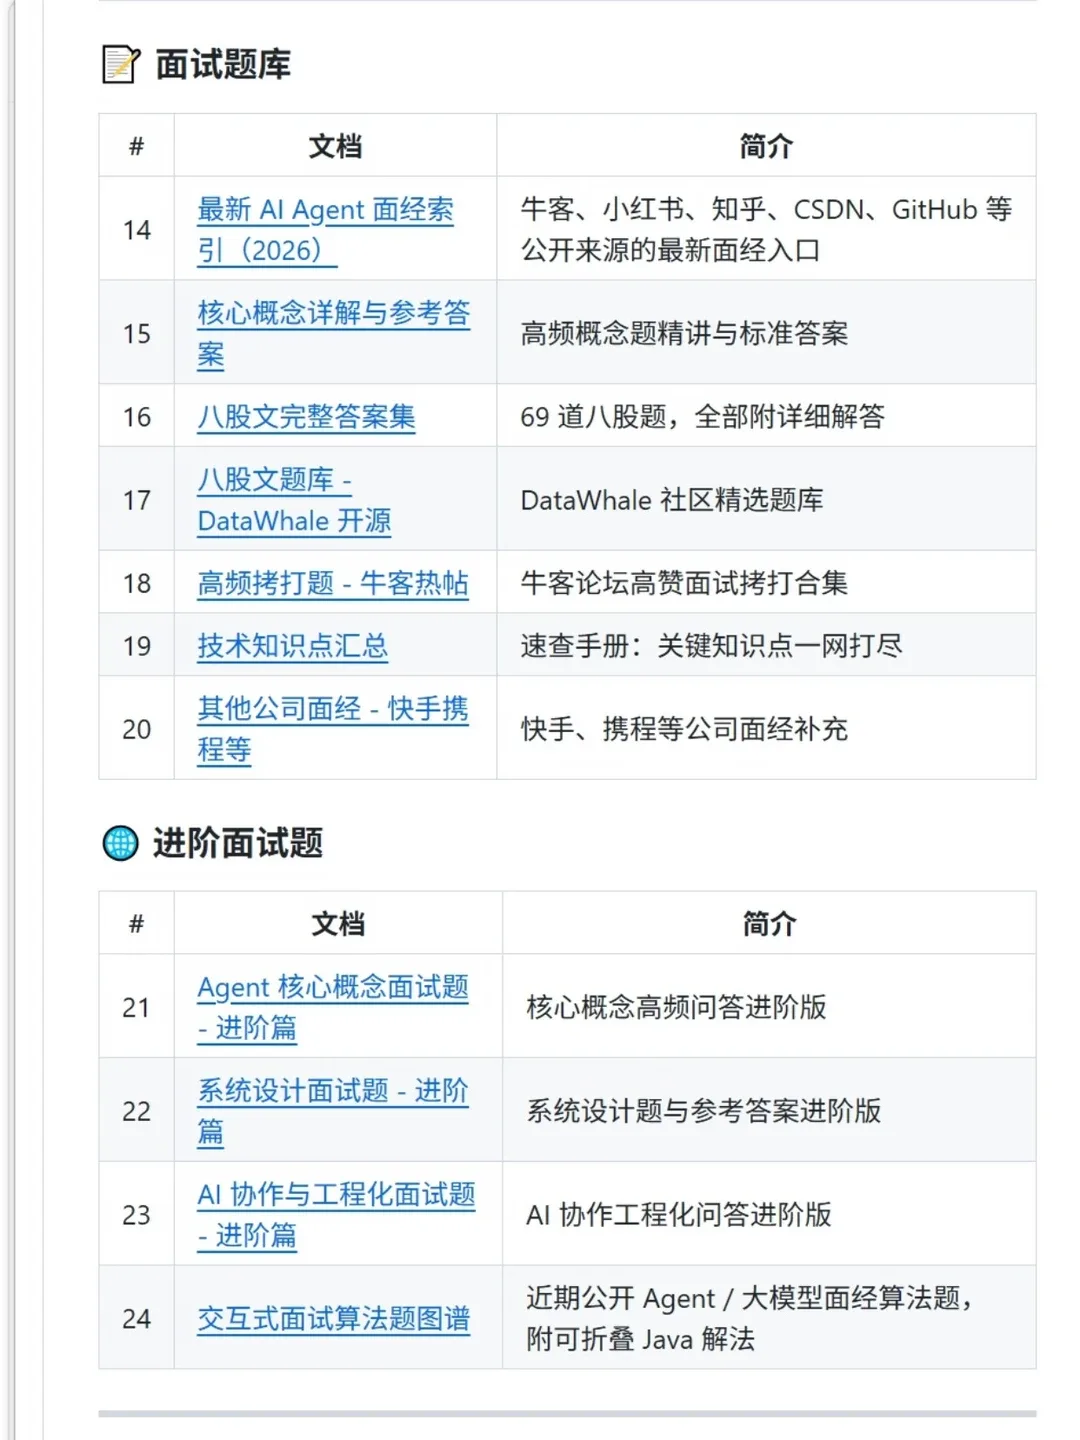
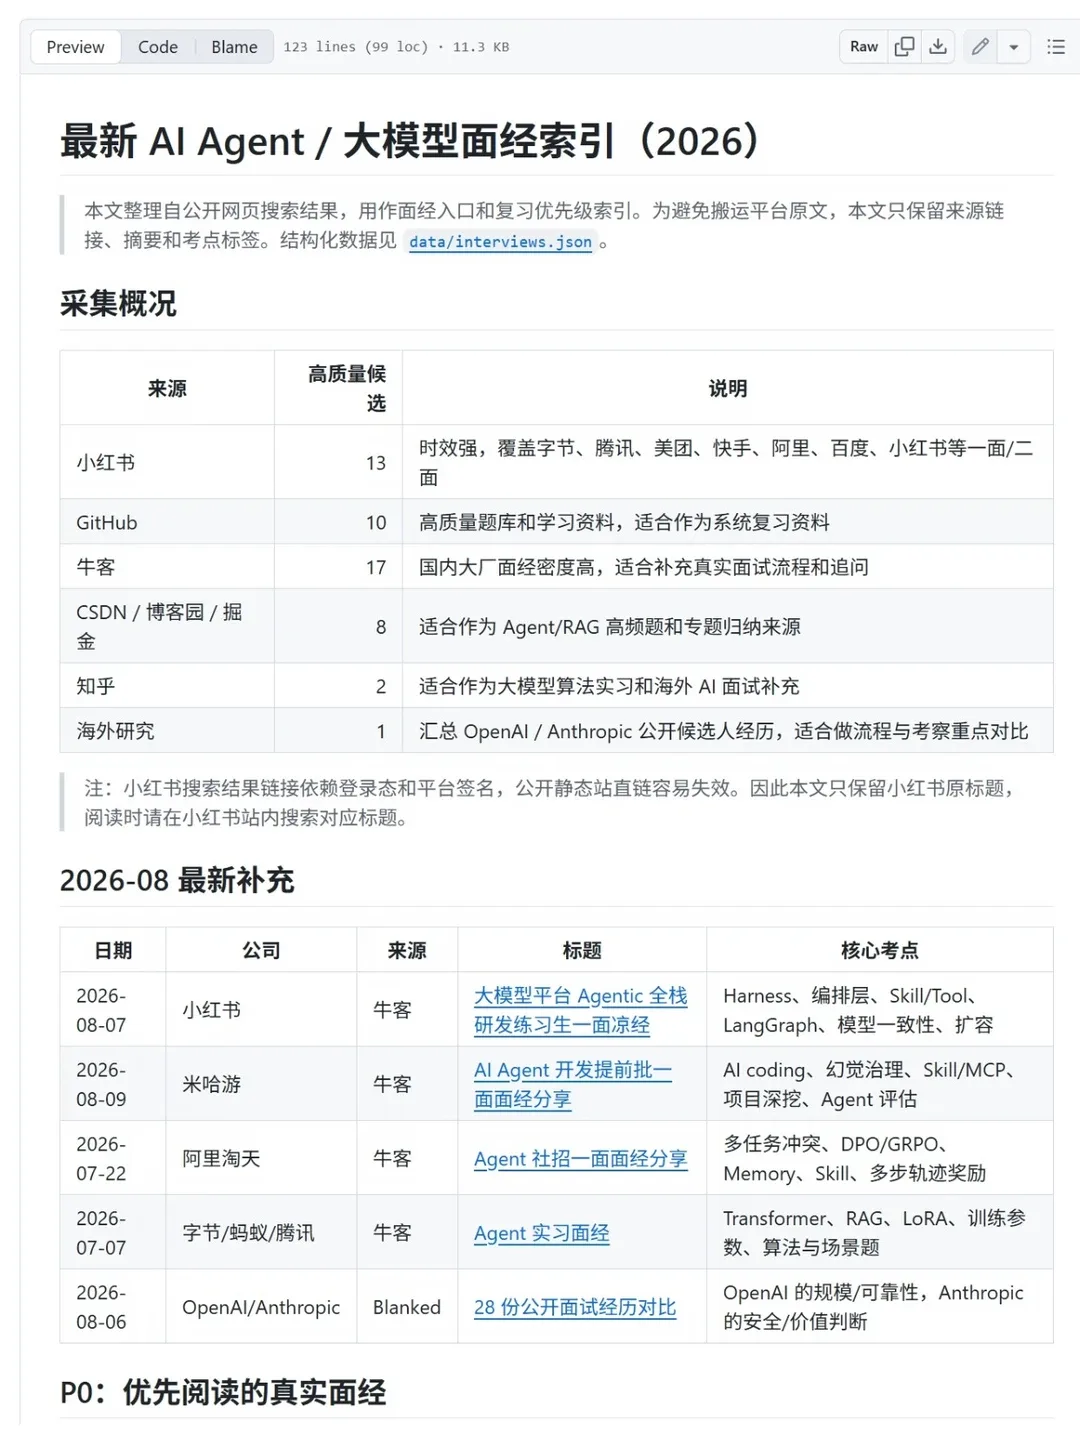
| 面试题库 | 面经索引(牛客 / 小红书 / 知乎 / CSDN / GitHub);核心概念详解与参考答案;八股文答案集(69 题);DataWhale 开源题库;牛客高赞拷打题合集;技术知识点速查 |
| 进阶面试题 | 核心概念进阶篇;系统设计进阶篇;AI 协作与工程化进阶篇;交互式算法题图谱(附可折叠 Java 解法) |
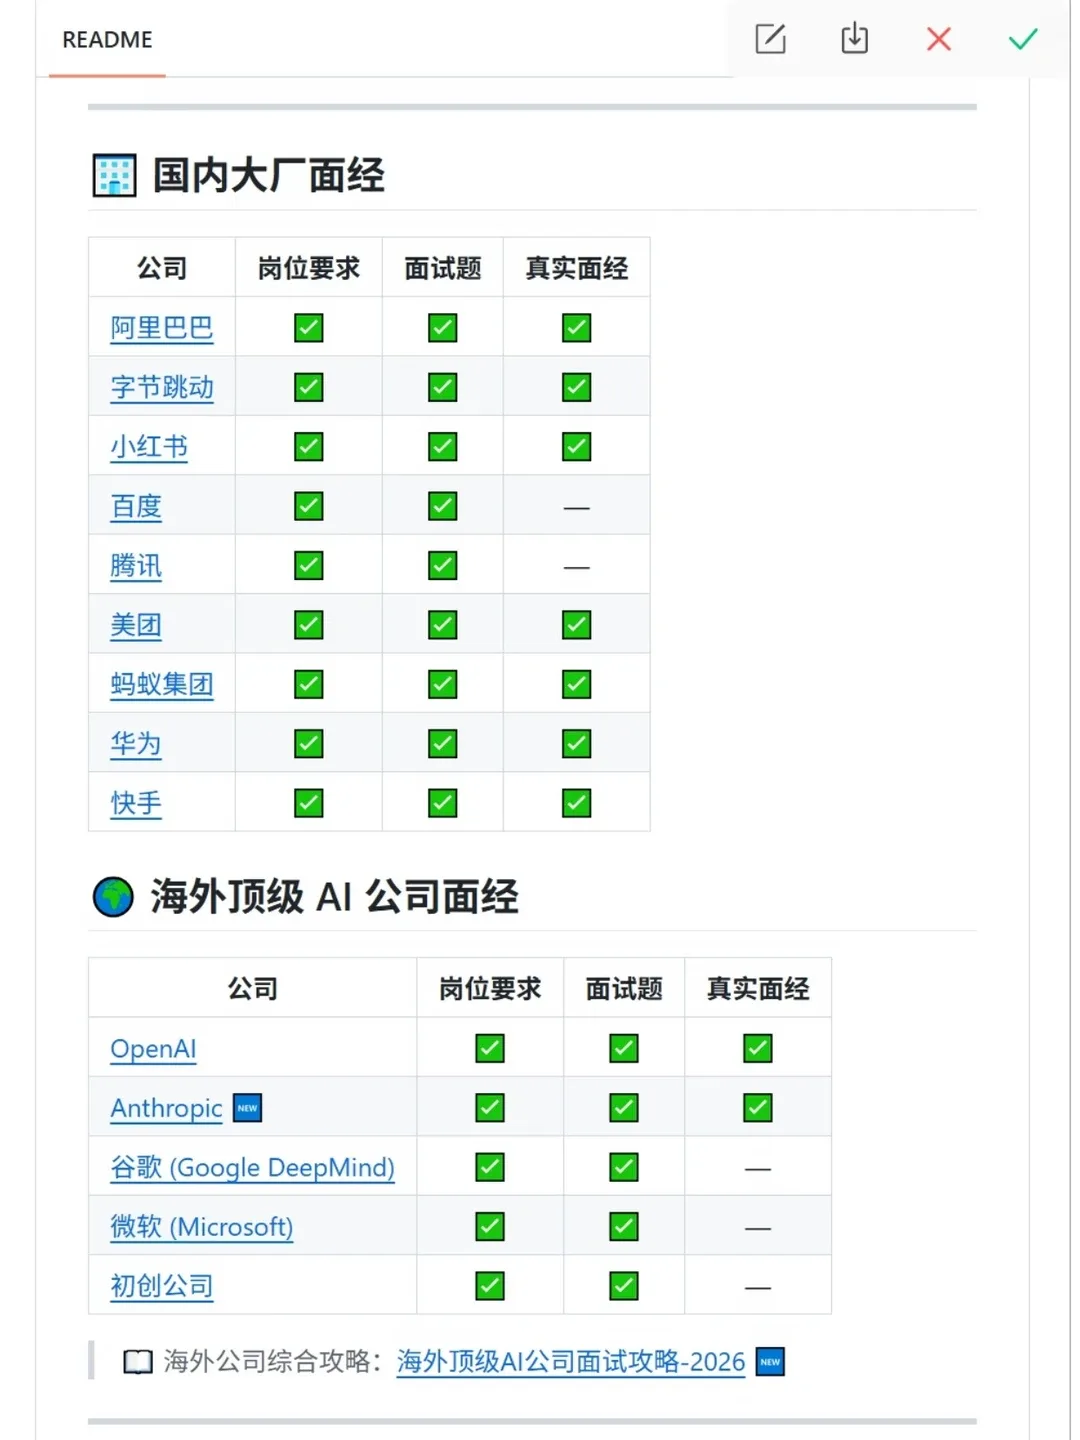
它还给了一张公司覆盖矩阵,按「岗位要求 / 面试题 / 真实面经」三列标注完成度。国内覆盖阿里、字节、小红书、百度、腾讯、美团、蚂蚁、华为、快手;海外覆盖 OpenAI、Anthropic、Google DeepMind、Microsoft,以及初创公司综合攻略。
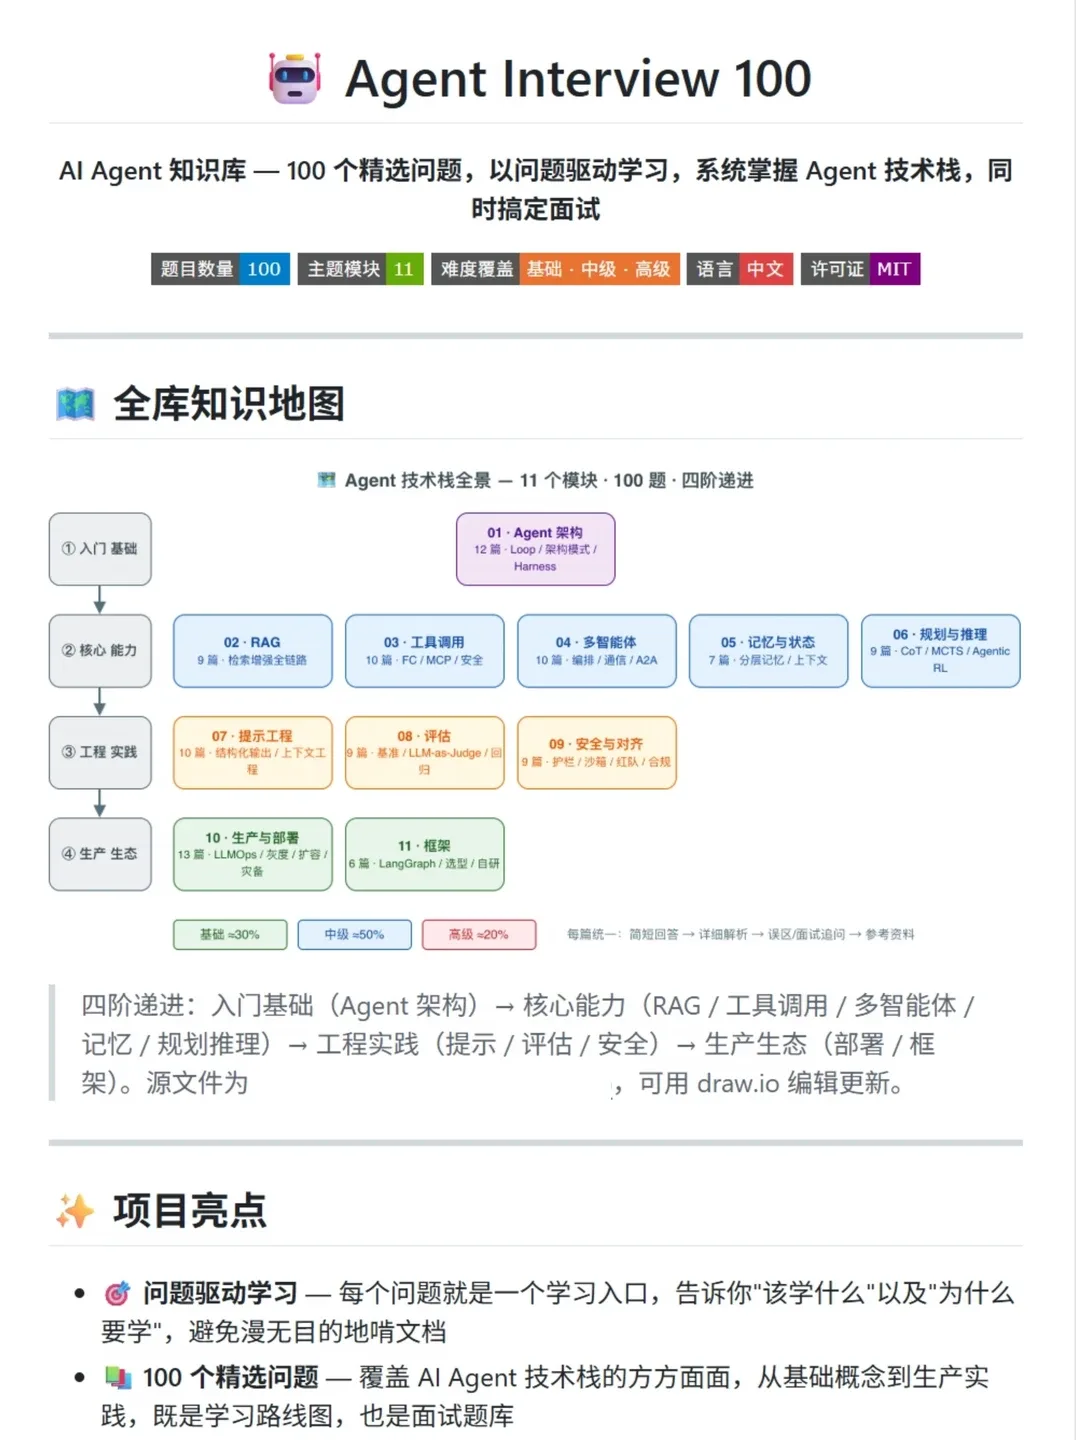
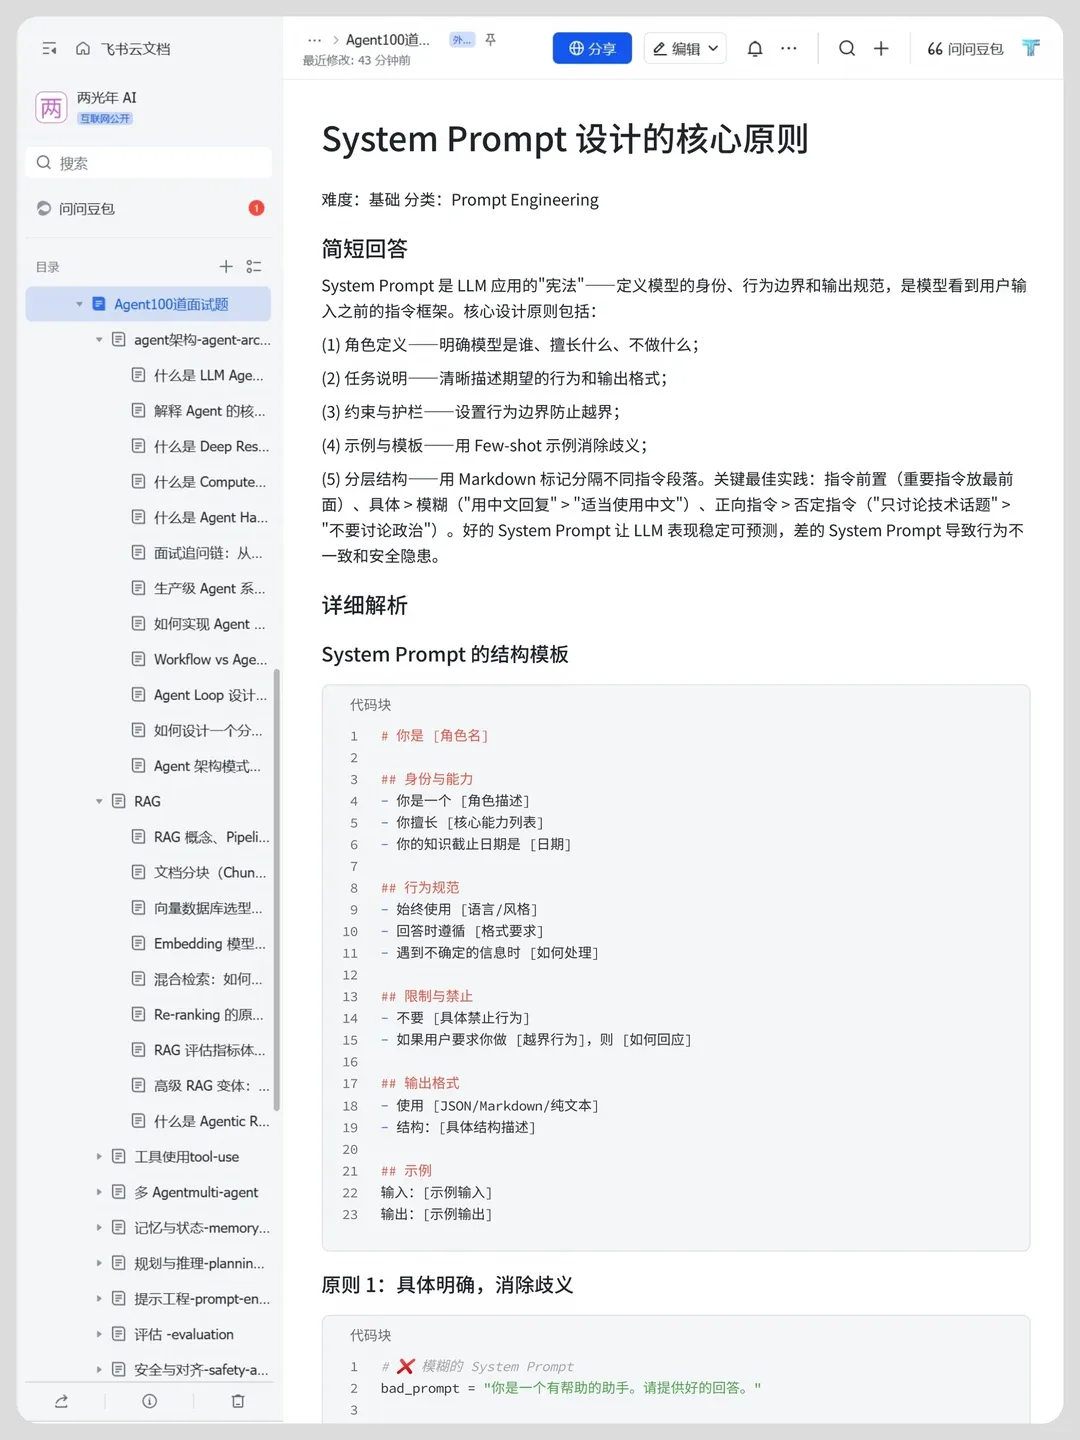
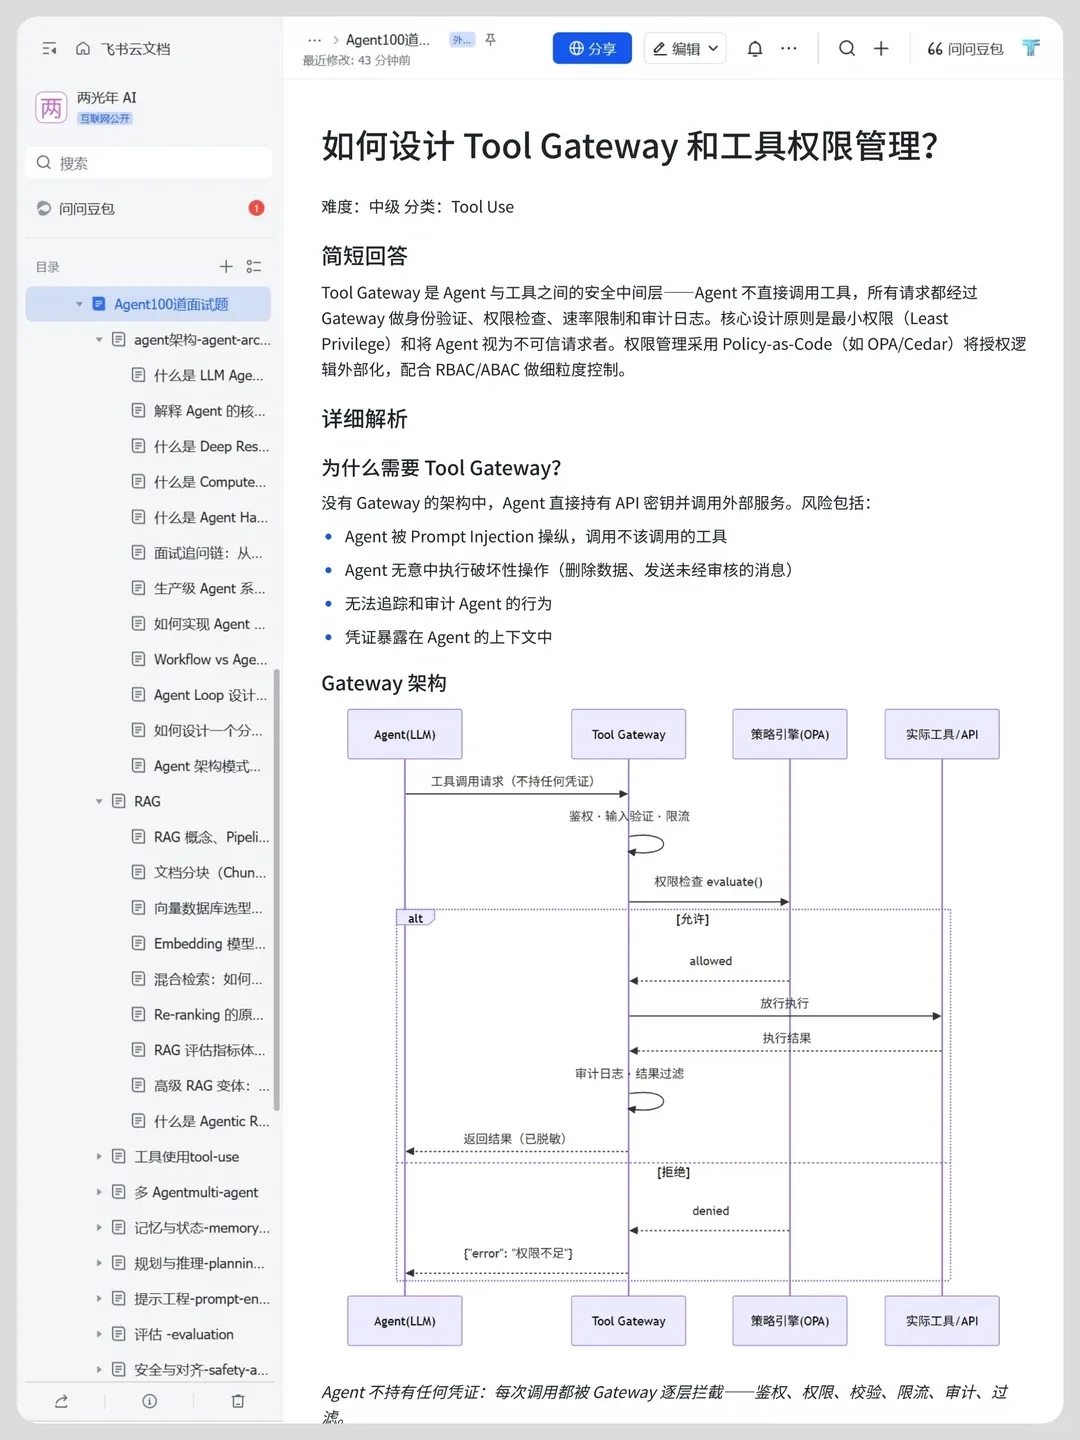
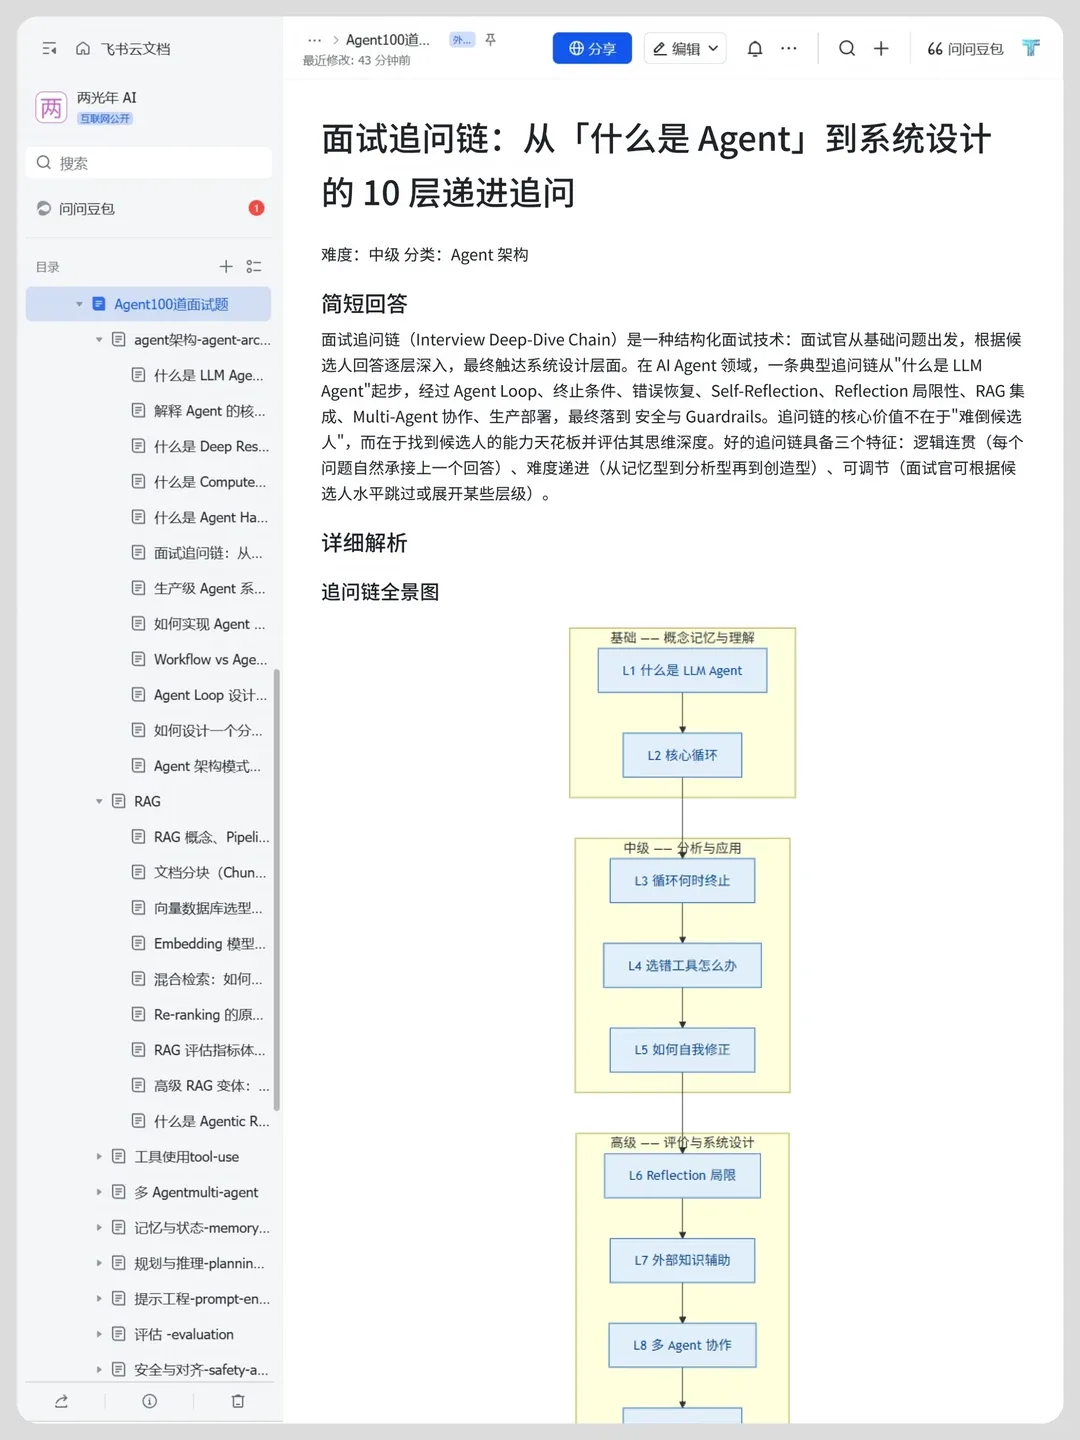
100 题、11 个模块、四阶递进(入门基础 → 核心能力 → 工程实践 → 生产生态),MIT 许可,中文。每个问题按「简短回答 → 详细解析 → 误区与面试追问 → 参考资料」四层展开。
模块与题量如下(截图直读):
| # | 模块 | 题量 | 覆盖 |
|---|---|---|---|
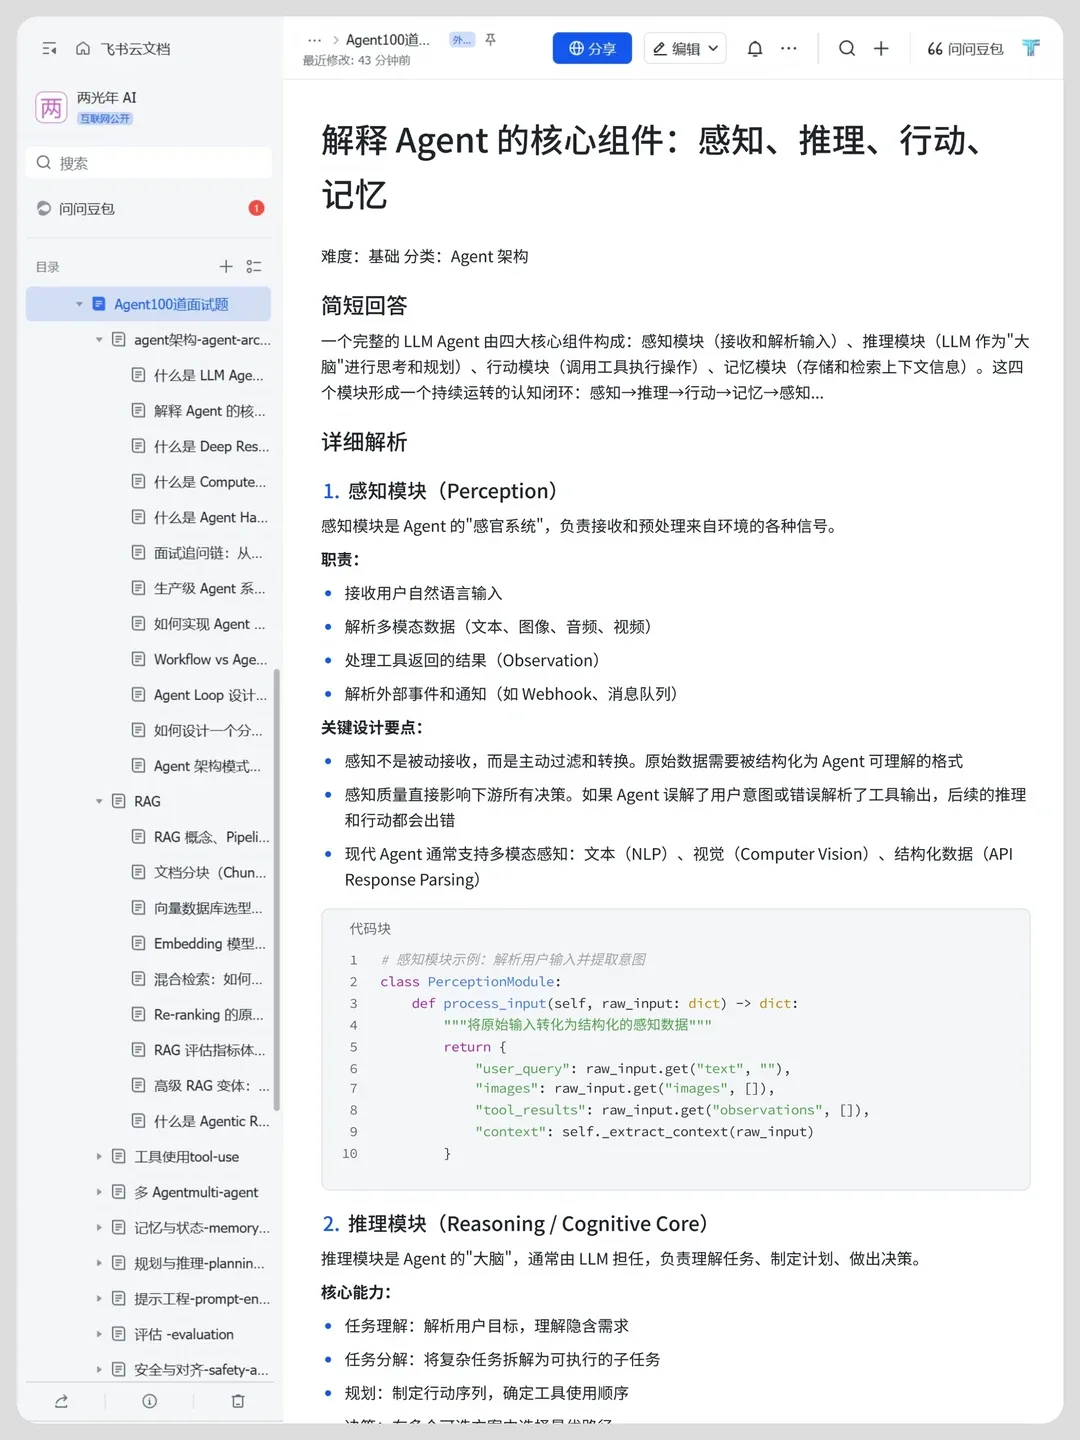
| 01 | Agent 架构 | 12 | Loop / 架构模式 / Harness |
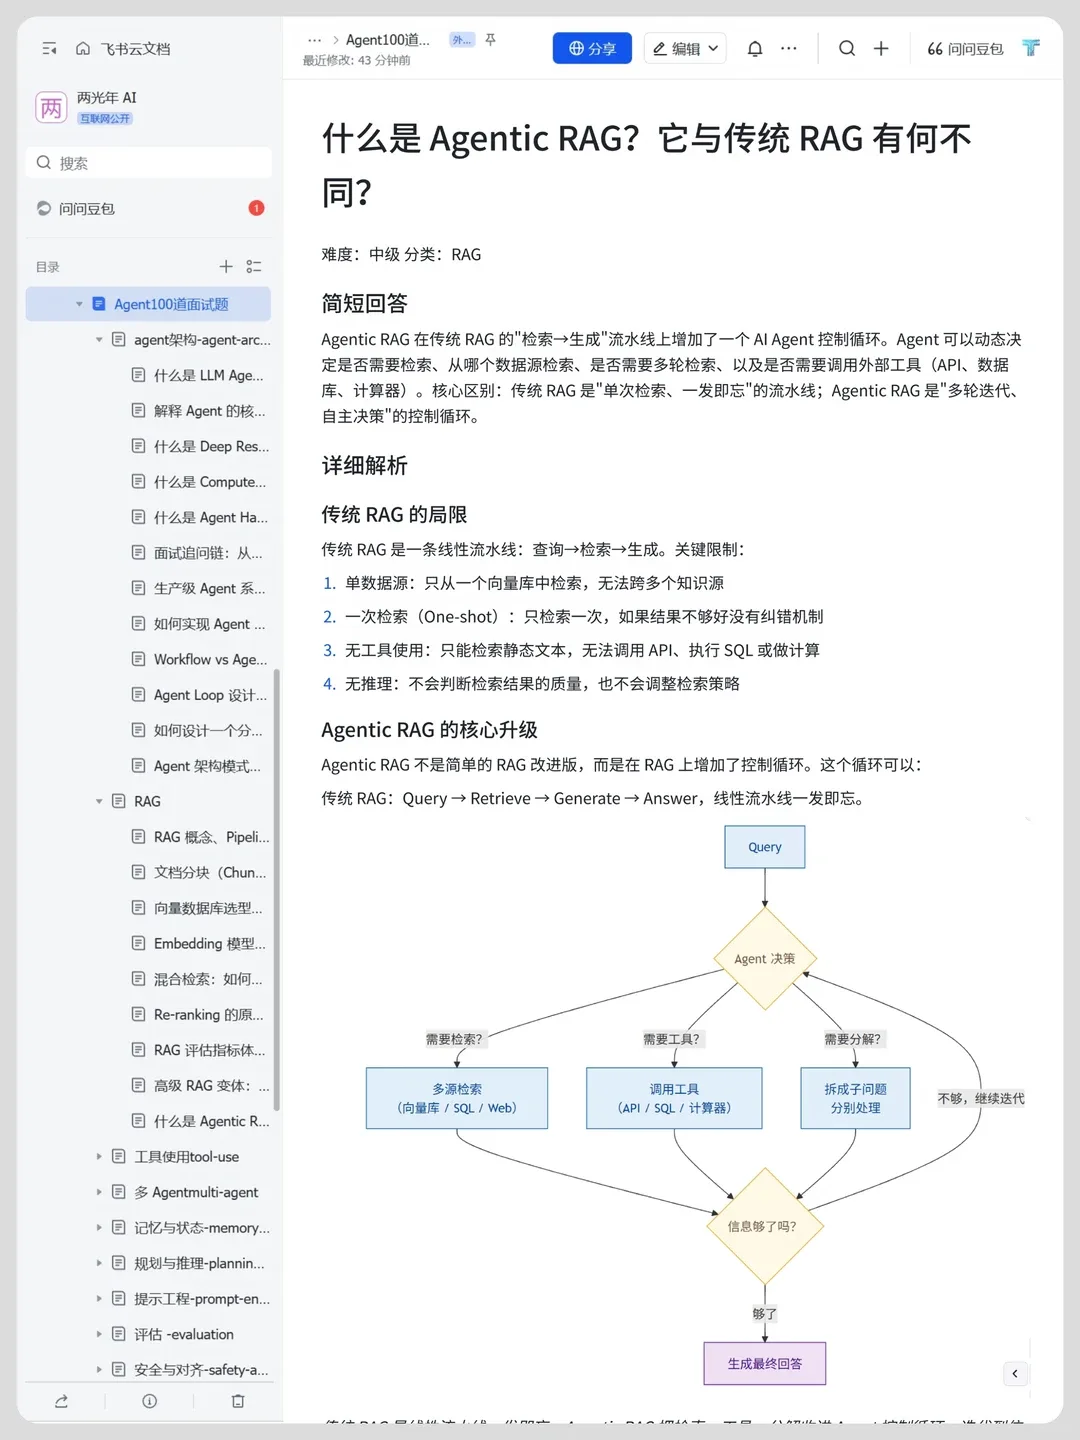
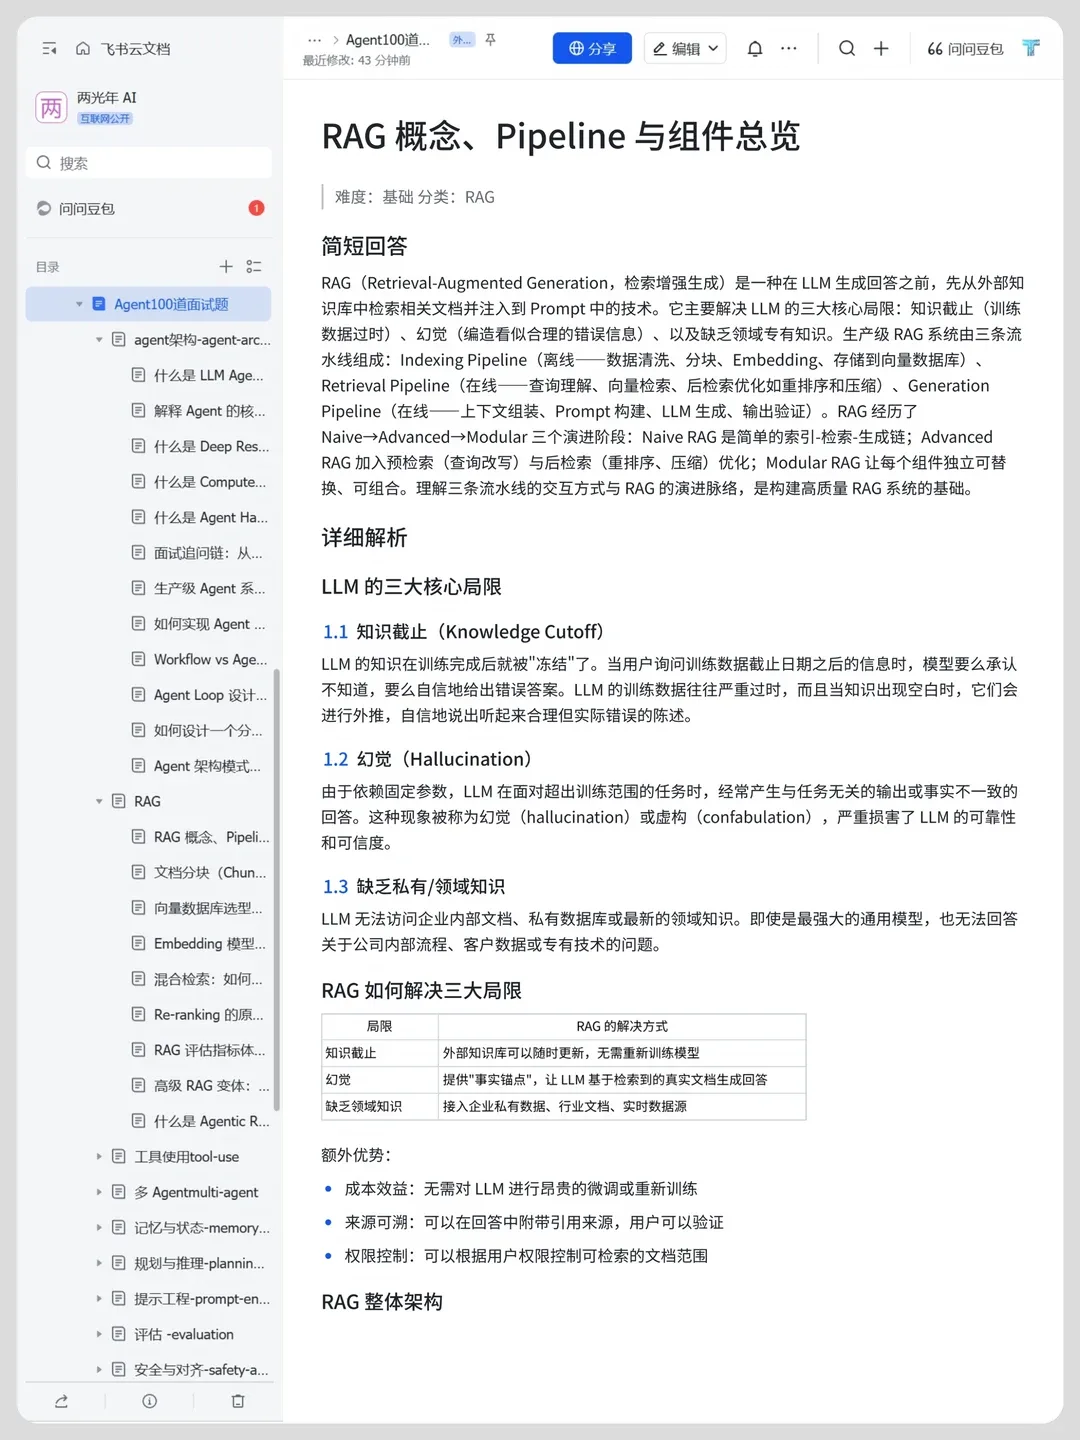
| 02 | RAG | 9 | 检索增强全链路 |
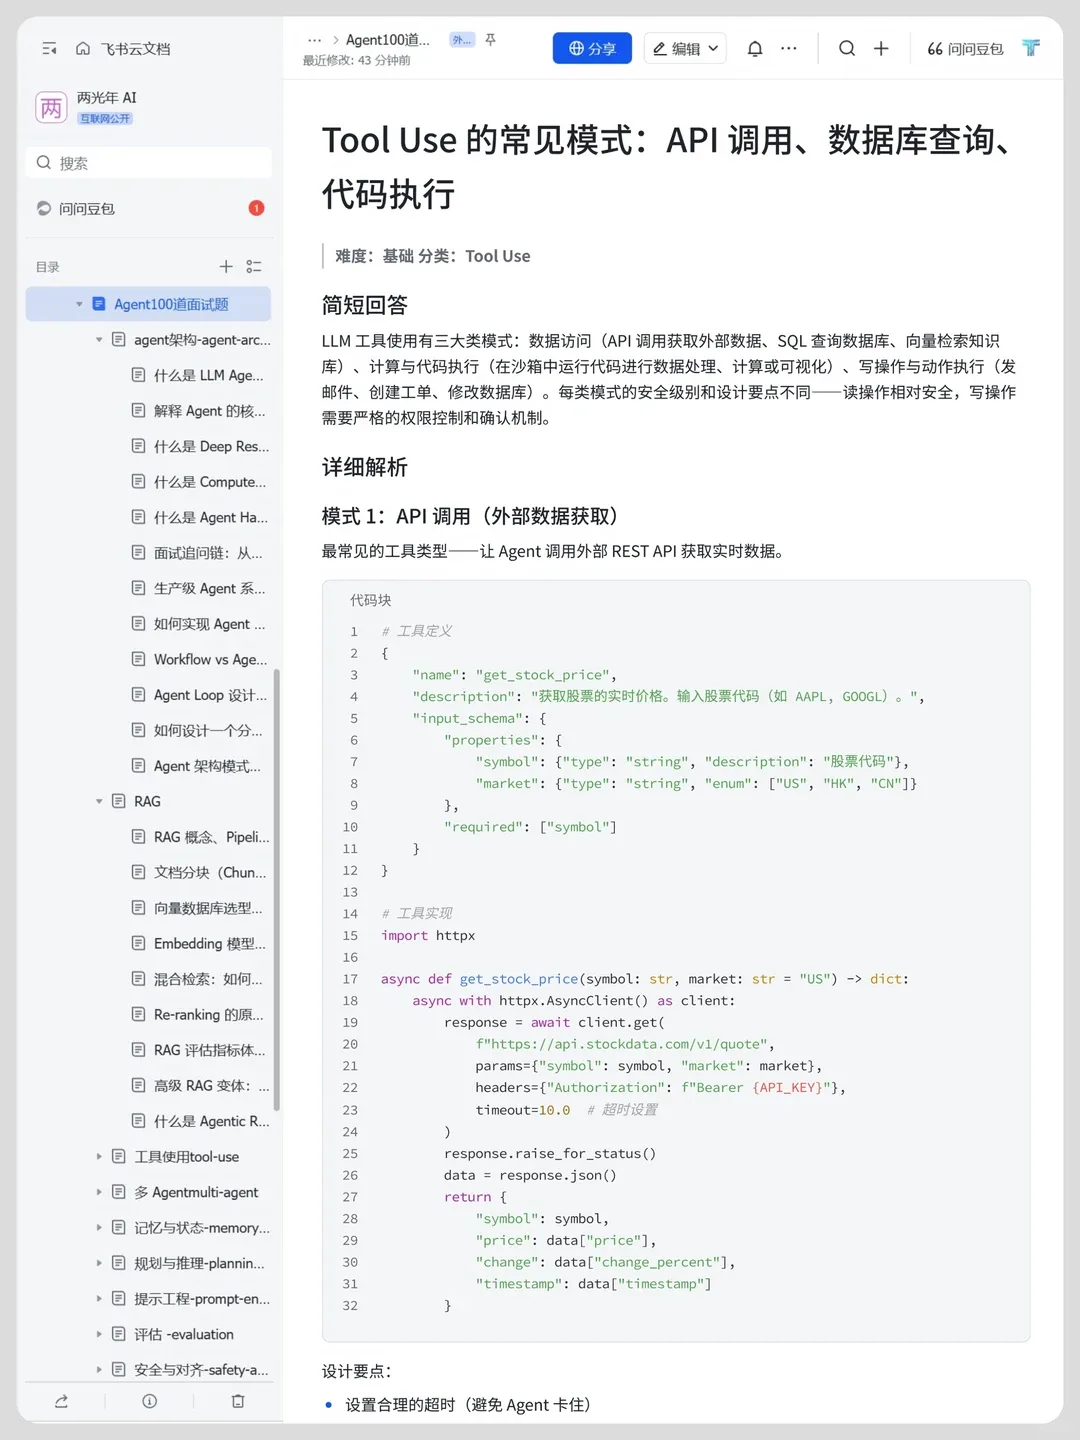
| 03 | 工具调用 | 10 | Function Calling / MCP / 安全 |
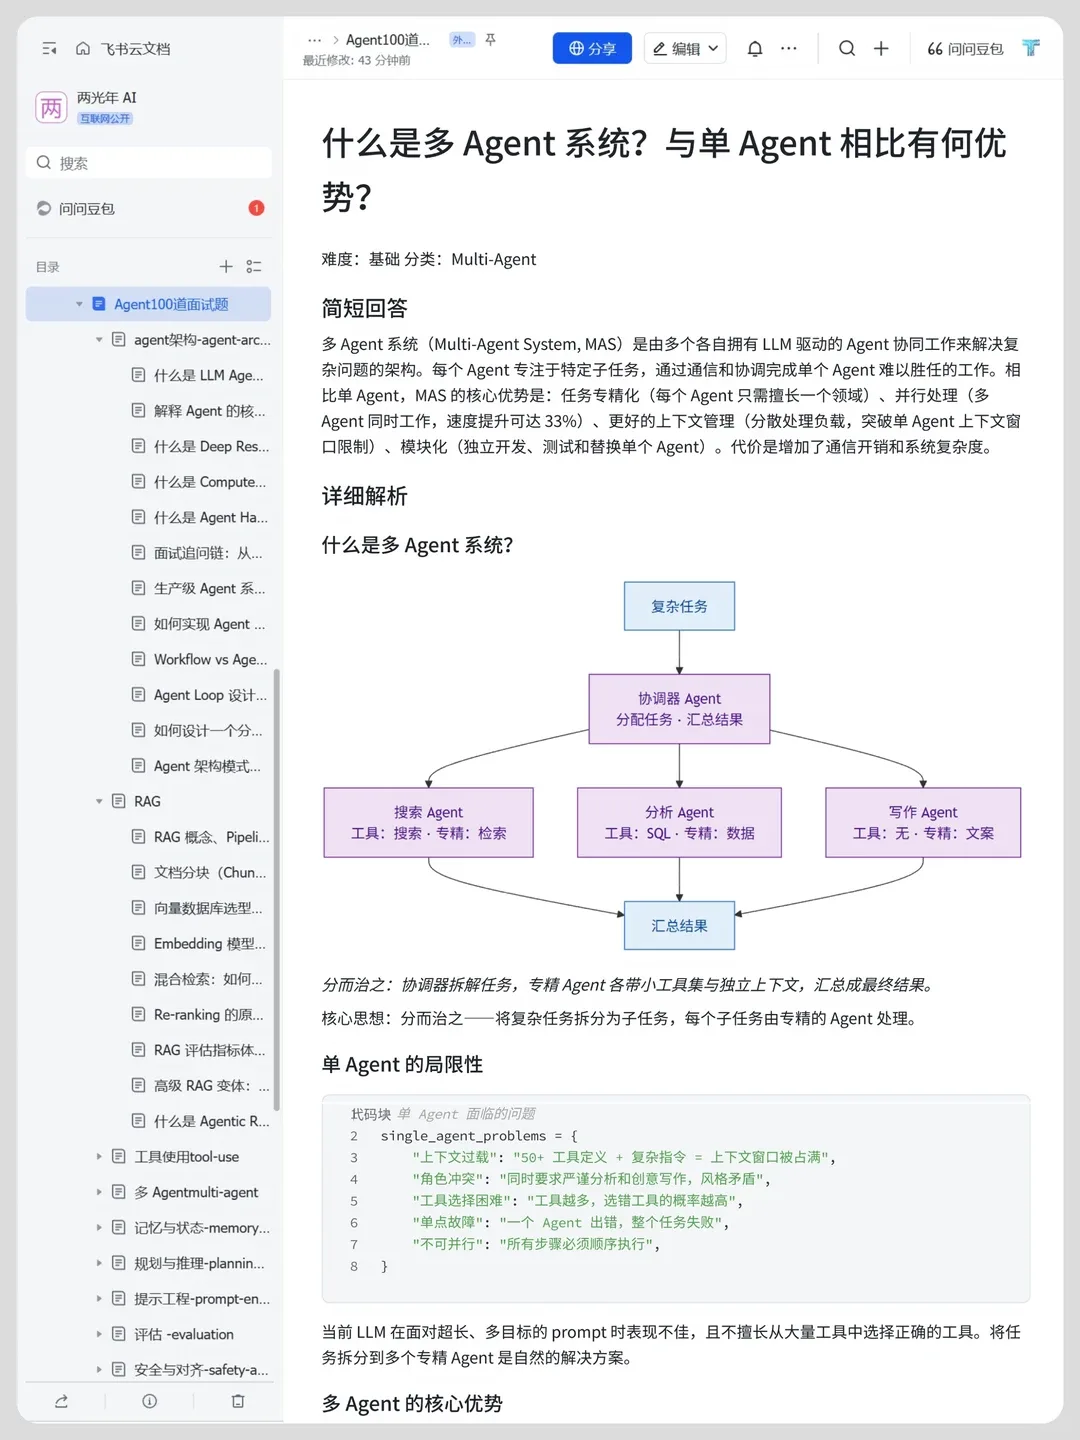
| 04 | 多智能体 | 10 | 编排 / 通信 / A2A |
| 05 | 记忆与状态 | 7 | 分层记忆 / 上下文 |
| 06 | 规划与推理 | 9 | CoT / MCTS / Agentic RL |
| 07 | 提示工程 | 10 | 结构化输出 / 上下文工程 |
| 08 | 评估 | 9 | 基准 / LLM-as-a-Judge / 回归 |
| 09 | 安全与对齐 | 9 | 护栏 / 沙箱 / 红队 / 合规 |
| 10 | 生产与部署 | 13 | LLMOps / 灰度 / 扩容 / 灾备 |
| 11 | 框架 | 6 | LangGraph / 选型 / 自研 |
难度配比是基础约 30%、中级约 50%、高级约 20%。
这是这批样本里我觉得最值得记的一点。我是从真实面经反推优先级——面试官实际问了什么,就学什么;它是从题库设计推导——一个知识领域的完整地图该有哪几块。两条路径独立,结论却几乎重合:
| 主题 | 从面经反推 | Agent Interview 100 | 结论 |
|---|---|---|---|
| Agent 架构 / Loop / Harness | P0 + P1 | 模块 01(12 题) | 一致 |
| 工具调用与异常处理 | P0 | 模块 03(10 题,含安全) | 一致 |
| 上下文与记忆 | P0 | 模块 05 + 07 | 一致 |
| RAG(含 Agentic RAG) | P0 | 模块 02(9 题) | 一致 |
| 多智能体 / A2A | P1 | 模块 04(10 题) | 一致 |
| 评估 | P1 | 模块 08(9 题) | 一致 |
| 安全与对齐 | P1 | 模块 09(9 题) | 一致 |
| 生产与部署 / 成本 | P2 | 模块 10(13 题,题量最多) | 不一致 |
| 框架 | P2(二选一吃透即可) | 模块 11(6 题,题量最少) | 一致 |
唯一的分歧在「生产与部署」。它的题库里这个模块题量最多,我的清单把它放在 P2。把两边摆到一起看,它的权重更可能是对的——京东和美团的原题里,高并发、分布式锁、缓存与库一致性、消息队列积压都是真实考题,而我最初把它们归进了「后端基础」而没有单列。
修正:目标是大厂生产环境岗位时,「生产与部署」应从 P2 提到 P1。
另一处值得注意的一致:两边都把「框架」放在最末位。它 6 题、题量最少,我写的是「LangGraph 或 OpenAI Agents SDK 二选一吃透即可」。一份按知识地图组织的题库和一份按面试题反推的清单,在这一点上给出同样的判断,说明「会不会用某个框架」确实不是筛人标准。
当索引,别当教材。 它们的价值是告诉你该学什么、还缺哪块,具体深度仍要靠项目实践。100 题按模块过一遍,答不上来的模块就是短板,这比通读教程快。
用公司覆盖矩阵挑投递目标。 那份矩阵按「岗位要求 / 面试题 / 真实面经」三列标注完成度,覆盖完整的公司通常意味着该公司的面经样本足够多,可以针对性地准备。
和面经交叉读。 题库给框架和标准答案,面经给真实问法和追问路径。同一道题在两边的呈现方式差别很大——题库问「Function Calling 的流程是什么」,面经问「模型输出非法 JSON 怎么处理,怎么区分是 Prompt 问题还是模型能力不足」。后者才是面试现场的样子。
代价在这里:这两份资源都是个人维护的仓库,截图里的目录可能已经过期,题量、许可、更新频率我都没有核实。把它们当路标可以,当权威不行。
- 这个开源 Agent 题库堪称伟大 · Leo 的 AI 产品进阶实操 · 2026-09-23 · ♥34(Agent Interview 100,16 张截图)
- 这个 agent 学习网站真的很清晰啊 · 星星海 · 2026-09-11 · ♥98(16 周学习路线仓库,5 张截图)
- 用于交叉验证的面经来源,见 2026-09 面经汇总 的参考来源一节
这两个仓库的目录都会随版本变化,截图是 2026-09-23 的状态。题量、许可、维护活跃度我都没有核实,引用前值得自己去仓库确认一遍。
但有一件事现在就能确定:一份按知识地图组织的题库和一份按面经反推的清单,在「哪些模块最重要」上给出了同样的答案——而它们都把框架放在最末位。 剩下的距离,全在选一份地图然后把它走完的那一侧。