Agent 实习要学什么:从 11 场面经、170 道原题反推的优先级
2026-09-10 到 09-23,14 天里,小红书 7 条查询返回 40 条候选,X 的 4 条查询跑 live / top 两路返回 27 条。我把其中 26 篇笔记的正文和长图逐篇读完,拿到 11 场面经、约 170 道原题——最多的一场 43 题、三轮、已 OC。
样本里有一件事比题目本身更值得记。一位面试官在同一天的复盘里写:
上午面了六个 Agent 应用开发岗,简历清一色写得很满:LangGraph、CrewAI、MCP、RAG、记忆系统,关键词基本全覆盖。但问到落地细节,大部分撑不过三轮追问。
六个关键词全覆盖的候选人,在第三轮集体失守。三个问题因此变得具体:
- 这 11 场面经里反复出现的能力,是哪几项?
- 哪些是 2026-07 之后才出现的?
- 按什么顺序学,才能让简历上的关键词撑到第三轮?
有几件事我做不到,先说清楚:我没参加过这些面试,题目全部来自面试者本人发布的自述,未经企业确认;小红书评论只翻得动首页(约 60 条上限);X 侧「Agent + 求职」的交集稀薄,它提供技术风向,不提供求职证据。全文我会逐条标注是「面试者原题」「面试官复盘」还是「从业者推文」。
| 优先级 | 学什么 | 判据(来自哪一问) | 达标标准 |
|---|---|---|---|
| P0 | 工具调用与异常处理 | 面试官复盘的第一层追问 | 能讲清 schema 校验、超时重试(指数退避)、降级兜底三层 |
| P0 | Agent 智能循环(Loop) | 虾皮第 2 题、影石第 8 题 | 能画出 接任务 → 思考 → 行动 → 观察 → 再决策 的闭环,并说清终止条件 |
| P0 | 上下文与记忆管理 | 面试官复盘第三层,虾皮第 4-5 题 | 能讲记忆分层、上下文压缩、关键信息优先召回 |
| P0 | RAG 进阶链路 | 虾皮第 6-8 题 | 能讲 Query Rewriting + Hybrid Search(BM25 + 向量)+ Rerank 的完整链路 |
| P0 | 手撕 + 后端基础 | 11 场里 8 场出现 | LRU、拓扑排序、合并有序数组、SSE 流式组装;MySQL 索引 / 日志、Redis、消息队列、线程池 |
| P1 | MCP 协议 | 同一场连问三题 | 能讲协议形态、如何与大模型结合、如何被调用 |
| P1 | Harness / Runtime / Sandbox | 字节 Infra 追问链、影石第 15-16 题 | 能解释 Harness 解决什么问题、Runtime 提供什么能力、沙箱怎么隔离 |
| P1 | 多 Agent 编排与状态机 | 虾皮第 1 题 | 能对比单 Agent / 多 Agent / Workflow 三种模式的取舍 |
| P1 | Agent 评测 | 已出现独立岗位 JD | 能讲 Rubric 设计、LLM-as-a-Judge 校准、Bad Case 归因闭环 |
| P1 | Agent 安全(Guardrails) | 寒武纪二面第 9-11 题 | 能讲提示注入的输入 / 输出侧拦截、命令注入与 SSRF 防护 |
| P1 | A2A 协议 | 寒武纪二面第 8 题 | 能一句话区分:MCP 管接工具,A2A 管 Agent 之间对话 |
| P2 | 可观测性与成本控制 | 寒武纪三面第 4 题 | 会用 LangSmith / Langfuse;能讲 Token 成本怎么控 |
| P2 | 训练侧概念 | 虾皮第 10 题 | 知道 SFT / RL / Agentic CFT 各解决什么,为什么 Mask Observation Token |
| P2 | 多模态 Agent | 虾皮第 9 题 | 知道视觉编码器输出如何与语言模型融合 |
| P2 | 国产算力适配 | 寒武纪三场贯穿 | 知道 MLU 与 CUDA 的推理差异、MagicMind 动态 shape 的影响 |
1. 工具调用与异常处理
面试官的追问从这里开始:模型调工具报错、参数不符合 schema、下游服务超时,代码层面怎么做异常处理?他记下的结果是「多数回答停留在 try-except 捕获一下,明显只跑通过正常路径」。
要答出三层,每一层都有对应的原题:
| 层 | 做法 | 原题 |
|---|---|---|
| 参数层 | 工具返回结果做 schema 校验,不合法就回灌错误给模型重生成 | 京东一面第 5 题 |
| 网络层 | 超时重试用指数退避,并设最大重试次数 | 美团面经第 2 题(附答案) |
| 业务层 | 异常链路降级到人工兜底或默认返回值,不静默失败 | 寒武纪一面第 15 题 |
美团那份面经给了完整的三层兜底写法:强约束 Prompt 限定 JSON 格式 → 代码层正则校验与字段补全 → 解析失败降级到预设固定工具流程。
2. Agent 智能循环
面试官现在的问法是把完整运行链路串起来讲一遍。字节 Agent 研发(基础设施)岗给出的追问链是:
1Agent Loop 怎么跑2→ Runtime 提供什么能力3→ Harness 解决什么问题4→ Memory 怎么设计5→ MCP / Skill 怎么接入6→ Sandbox 怎么提供执行环境
必答的收敛机制有四项:最大迭代步数、重复动作检测、熔断、Token 预算上限。已入职者复盘的版本更直接:「Agent 调了三个工具后开始死循环,异常处理写在哪?」
3. 上下文与记忆管理
面试官复盘里有一句判词:简历上写「精通记忆系统」的,一问上下文管理就暴露了。他给的场景是——用户对话到第二十轮,Agent 丢失了最早的关键信息,排查路径是什么?
三种病因要能区分:没做记忆分层(短期 / 长期 / 工作记忆);长期记忆召回策略有问题;上下文窗口被塞爆,关键信息被挤掉。
美团的答案给了一条可背的原则:统一写入与更新规则,关键业务数据做固定锚点不可被后续对话覆盖,每次推理前优先加载核心记忆。
4. RAG 进阶链路
只会「文档切片 + 向量检索」已经不够。虾皮连问三题,把链路拆成了:
1Query Rewriting → Hybrid Search(BM25 + 向量)→ Rerank → 上下文组装
对应的原题分别是父子索引(第 6 题)、BM25 与向量的结合方式及 Rerank 位置(第 7 题)、知识库持续更新时的索引更新与缓存失效(第 8 题)。寒武纪还把「传统 RAG 和 Agentic RAG 的核心差异」做成了独立问题——考的是 Agent 如何自主判断检索次数、如何动态改写 query。
5. 手撕 + 后端基础
后端八股没有因为岗位名字里有「Agent」而消失。11 场里 8 场出现,字节 Infra 那场后半段基本就是标准后端考察。
出现过的算法题:LRU(字节)、拓扑排序 / 循环依赖检测(字节)、反转链表(京东)、合并两个有序数组(影石)、三数之和(百度)、SSE 流式工具 delta 组装(多家)、重复行检测(内存放不下时怎么做)、以及三道包装过的变形题——去重保序(寒武纪一面,LeetCode 316)、循环检测(寒武纪二面,LeetCode 202)、关键路径(寒武纪三面,LeetCode 207)。
出现过的后端题集中在 MySQL、Redis、消息队列、并发四块。京东把 RocketMQ 消息积压和 Redis 缓存穿透 / 击穿 / 雪崩放进了同一场。
6. MCP 协议
同一场面试里连问三题:实现方式有哪些、streamable 格式是什么、如何与大模型结合并调用。有从业者把它类比为当年的 REST API,属于刚需。
7. Harness / Runtime / Sandbox
这是 2026 年 9 月最明显的新增概念。X 上一条 2495 赞的帖子把 Harness 定义为四件事:让模型在循环里持续工作;给它读文件 / 调工具 / 跑代码的手;管理记忆;约束它能碰什么、何时必须停下来问人。
影石把「Harness 为什么可能提升 Agent 的任务完成能力」做成了正式考题,问的是原理不是名词。字节 Infra 那场则要求把 Harness / Runtime / Sandbox 三层的能力边界分开讲。
8. 多 Agent 编排与状态机
虾皮第 1 题直接问三种模式的取舍。面试官复盘里的追问更狠:为什么选状态机而不是线性 Chain?分支执行失败怎么回滚?
真正上线过的人会讲节点级可重试设计、分支判定逻辑、防止单点故障拖垮整条链路。寒武纪二面还要求分别说明 Supervisor / 群聊 / 流水线 / 层级四种拓扑的适用场景。
9. Agent 评测
小红书上已经出现专门的「Agent 评测工程师」岗位拆解,拆了 10 个 JD(阿里 / 网易 / 小红书等)。核心要求是评测体系从 0 到 1 与 Bad Case 归因;评测方法是规则校验 → LLM-as-a-Judge → 人工评审,核心在设计 Rubric 和校准 Judge。
代价在这里:LLM-as-a-Judge 本身有位置偏见和长度偏见,寒武纪把「工程中如何规避与消除」做成了独立问题。会写 Judge 只是入场,能校准 Judge 才算达标。
10. Agent 安全
寒武纪二面成体系考了三题:工具调用的参数校验与命令注入防护、SSRF 在 Agent 系统中如何暴露、提示注入在输入侧和输出侧分别要拦什么。防护机制要对得上 OWASP LLM Top 10。
11. A2A 协议
原题是「A2A 和 MCP 的核心区别是什么?为什么企业级 Agent 系统需要同时集成两套协议能力?」一句话记法:MCP 管 Agent 怎么接工具,A2A 管 Agent 之间怎么对话。
12. 可观测性与成本控制
从业者建议里反复出现 LangSmith / Langfuse,以及「想卷赢别人,重点搞这三个:沙箱隔离、记忆管理、Token 成本优化」。寒武纪把它做成了决策题:线上出现无限循环、步数爆炸、算力过度消耗、成本飙升,优先调哪三个开关快速止损。
13. 训练侧概念
只在偏算法岗出现。虾皮第 10 题问 SFT、强化学习、Agentic CFT 分别解决什么问题,以及为什么需要 Mask Observation Token。
14. 多模态 Agent
虾皮第 9 题:视觉编码器提取的信息如何与语言模型融合。
15. 国产算力适配
只投国产芯片公司才需要。寒武纪三场贯穿:LangGraph 状态数据存哪最优、MLU 与 CUDA 栈的推理差异、MagicMind 动态 shape 对上层编排的反向压力、算力只有 A100 的 60% 时优先裁剪哪些层级。
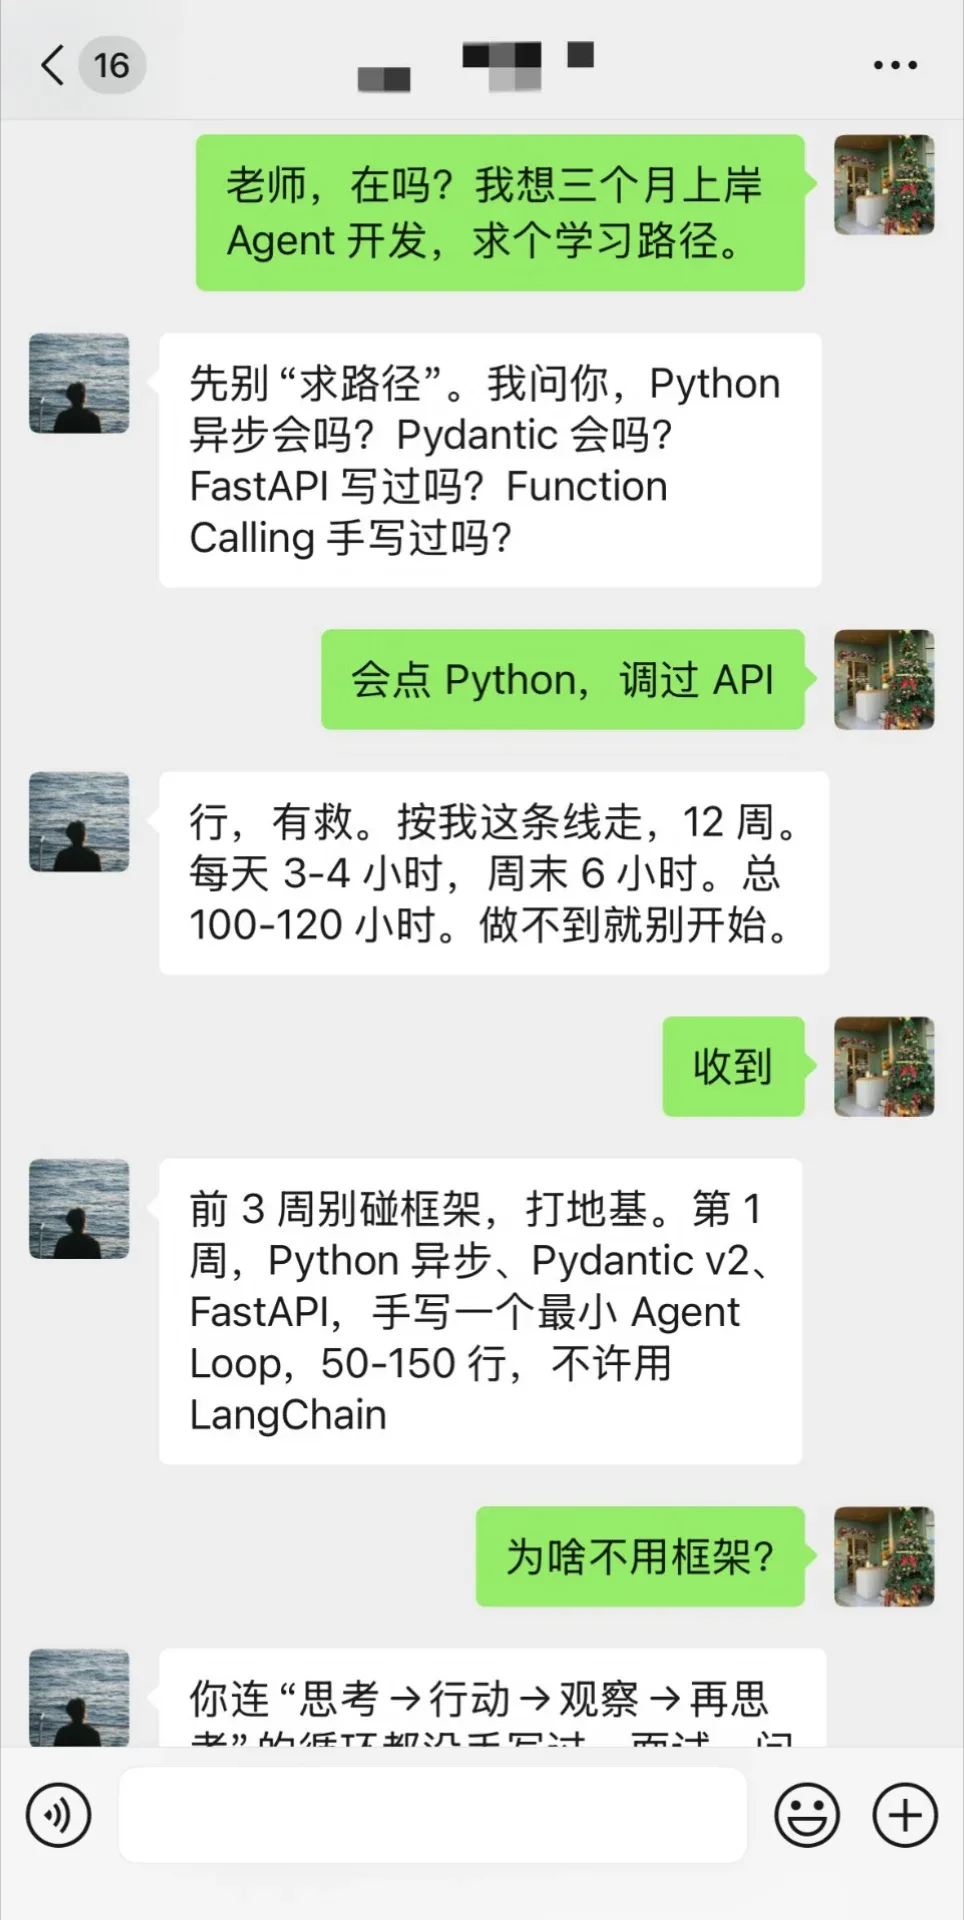
互动最高的一条学习路线帖(798 赞)给了明确的投入口径:每天 3-4 小时、周末 6 小时,总 100-120 小时。它的取舍标准和上面从面经反推的结论高度重合,所以直接采用:
| 周 | 主题 | 关键任务 |
|---|---|---|
| 1 | 打地基 | Python 异步 + Pydantic v2 + FastAPI;手写最小 Agent Loop(50-150 行,不许用 LangChain) |
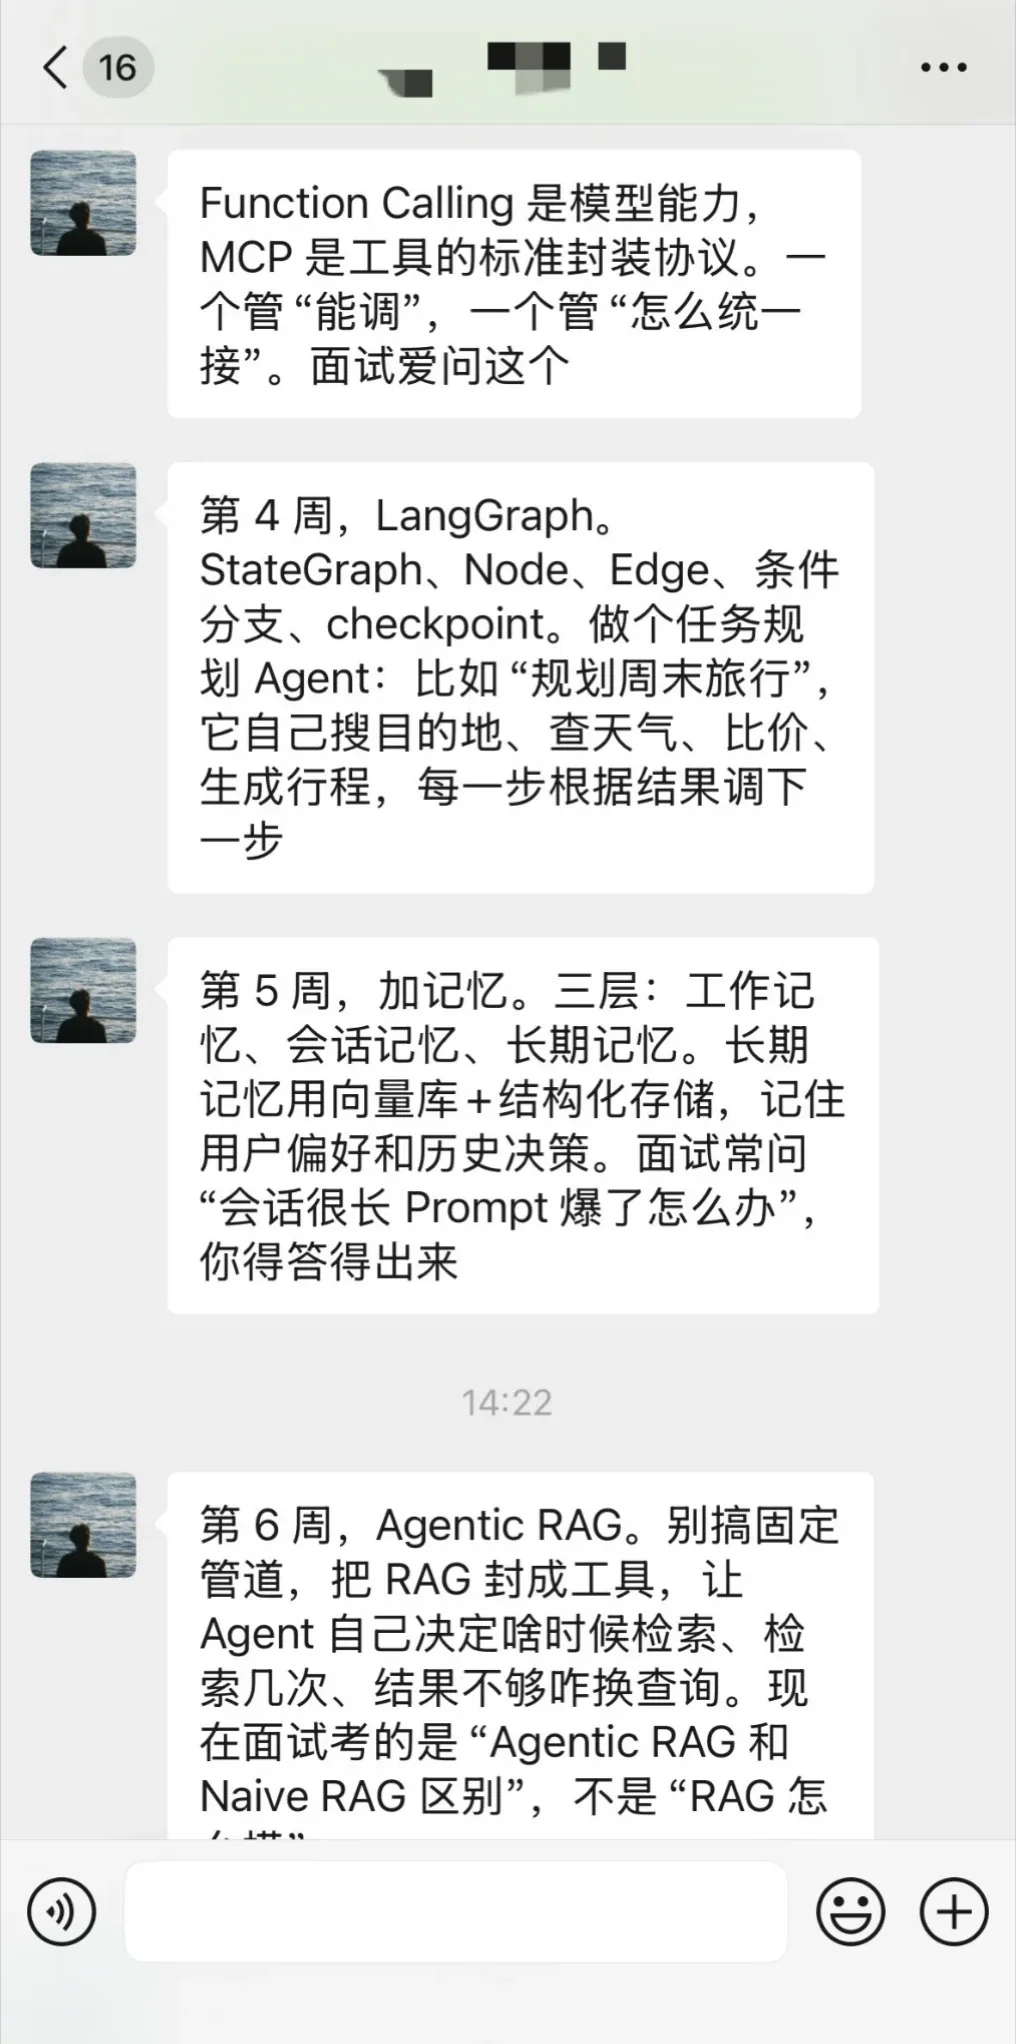
| 2 | Function Calling | 定义工具 schema,写 5 个工具(天气 / 汇率 / 待办 / 日历 / 搜索),把超时、参数错、模型瞎编工具名全处理一遍 |
| 3 | MCP | 用 FastMCP 写一个文件系统 MCP Server(读 / 写 / 列目录 / 搜内容),部署到云函数 |
| 4 | LangGraph | StateGraph、Node、Edge、条件分支、checkpoint;做一个任务规划 Agent |
| 5 | 记忆 | 三层记忆:工作 / 会话 / 长期;长期用向量库 + 结构化存储 |
| 6 | Agentic RAG | 别搞固定管道,把 RAG 封成工具,让 Agent 自己决定何时检索、检索几次、结果不够怎么换 query |
| 7 | 多 Agent | Supervisor 模式搭写作团队;同时想清楚什么时候不该用多 Agent |
| 8 | 评估与可观测性 | Langfuse 追调用链、RAGAS 评检索与生成;写一份可靠性报告(正常指标 / 对抗测试 / 失败模式) |
| 9 | 部署与安全 | Docker 打包、FastAPI 接口、流式输出;Guardrails 防注入、OWASP LLM Top 10、成本分级 |
| 10 | 打磨项目 | 精选 2-3 个(Agentic RAG / 多 Agent 协作 / MCP Server),README 带架构图,代码有类型注解、错误处理、测试 |
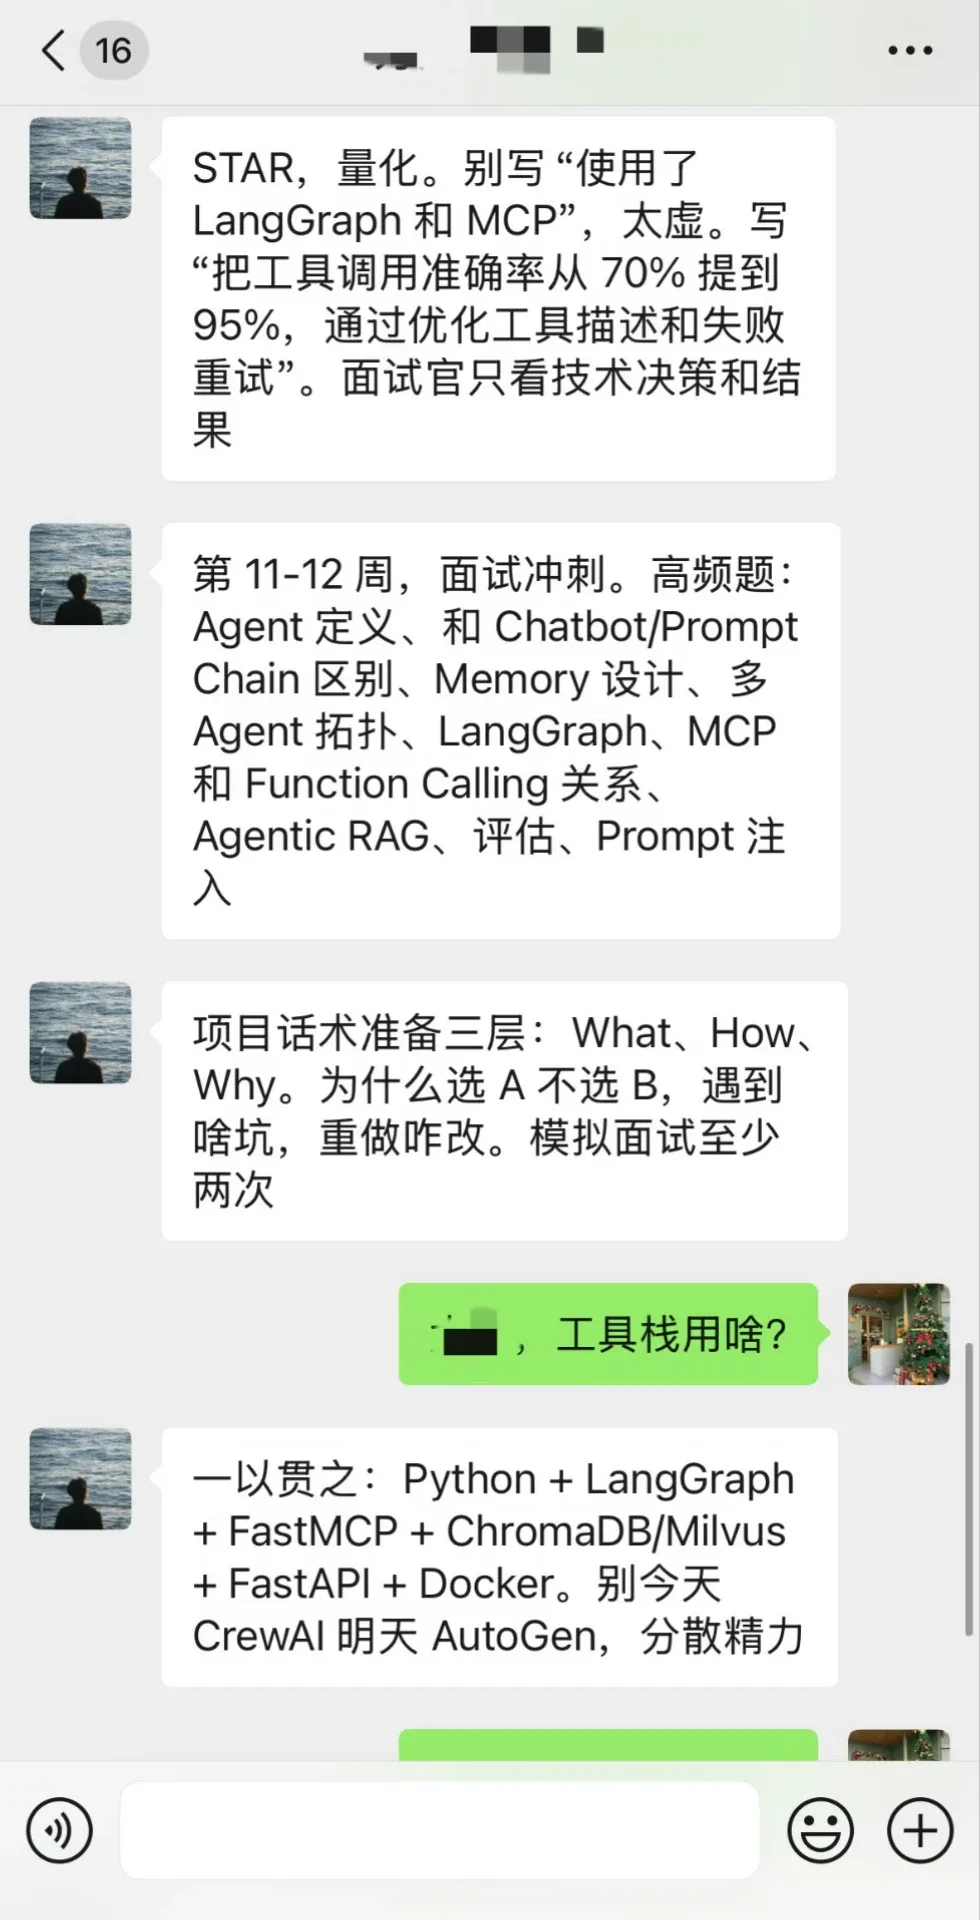
| 11-12 | 面试冲刺 | 高频题 + 项目话术三层(What / How / Why)+ 至少两次模拟面试 |
工具栈一以贯之:Python + LangGraph + FastMCP + ChromaDB / Milvus + FastAPI + Docker。
三条最硬的判断:前 3 周不许用框架,因为「你连思考 → 行动 → 观察 → 再思考的循环都没手写过,面试一问就露馅」;Agent 和 Chatbot 的区别只有一句,Chatbot 单次问答、Agent 自主闭环;没 eval 的系统就是 demo。
简历写法上,那份帖子的建议是把「使用了 LangGraph 和 MCP」换成「把工具调用准确率从 70% 提到 95%,通过优化工具描述和失败重试」——面试官看的是技术决策和结果。
调研中翻出一份开源题库(Agent Interview 100,100 题 / 11 模块)。它是从题库设计推导优先级,和本文从面经反推的路径独立,两边结论几乎一致:
| 主题 | 本文 | Agent Interview 100 | 结论 |
|---|---|---|---|
| Agent 架构 / Loop / Harness | P0 + P1 | 模块 01(12 题) | 一致 |
| 工具调用与异常处理 | P0 | 模块 03(10 题,含安全) | 一致 |
| 上下文与记忆 | P0 | 模块 05 + 07 | 一致 |
| RAG(含 Agentic RAG) | P0 | 模块 02(9 题) | 一致 |
| 多智能体 / A2A | P1 | 模块 04(10 题) | 一致 |
| 评估 | P1 | 模块 08(9 题) | 一致 |
| 安全与对齐 | P1 | 模块 09(9 题) | 一致 |
| 生产与部署 / 成本 | P2 | 模块 10(13 题,题量最多) | 不一致 |
| 框架 | P2(二选一吃透) | 模块 11(6 题,题量最少) | 一致 |
唯一的分歧在「生产与部署」。它的题库里这个模块题量最多,本文把它放在 P2。把京东和美团的原题摆在一起看,这个权重更可能是对的——高并发、分布式锁、缓存与库一致性、消息队列积压都是真实考题,而我最初把它们归进了「后端基础」而没有单列。
修正:目标是大厂生产环境岗位时,「生产与部署」应从 P2 提到 P1。
26 篇笔记里,寒武纪三轮、京东三轮、美团三份的正文全部在长图里。四条路径里只有一条能走通:
| 尝试 | 结果 |
|---|---|
xiaohongshu download | Navigation rejected |
xhs-media(iPhone UA 抓 HTML) | 抓到「你访问的页面不见了」,0 张图 |
| curl 原图 URL(剥掉后缀) | 403 |
| curl 原图 URL(沿用自带后缀)+ Referer | 200 |
完整的链路是:浏览器会话打开笔记页 → 读 window.__INITIAL_STATE__.note.noteDetailMap 的 imageList 拿原图签名 URL → 换成 https、沿用 URL 自带的渲染后缀 → 带 Referer 下载 → 转 png 后逐张读。后缀不固定(多数是 !nd_dft_wlteh_webp_3,也见过 !nd_dft_wgth_webp_3),写死会静默失败,所以下载后要校验文件体积。
面经原题(11 场,按题量排):
- 寒武纪 AI Agent 开发 面经三轮 · 喵喵星人 · 2026-09-12 · ♥107 · 43 题
- 京东 AI Agent 开发岗面经 · 抹茶小熊 · 2026-09-10 · ♥163 · 25 题
- 美团 AI Agent 开发面经(10 题附答案) · 小小琦 · 2026-09-15 · ♥21
- 影石创新 AI Agent 两轮面试 · 唯心不易 · 2026-09-16 · ♥62 · 23 题
- 虾皮 Agent 开发一面 9.15 · 每天学一点面经 · 2026-09-15 · ♥102 · 14 题
- Agent 面试复盘:LangGraph 底层被问穿 · Pony~_~ · 2026-09-11 · ♥119 · 16 题
- 字节 AI Agent 开发岗|2026-09-10 面经复盘 · 噜噜蹲面经 · 2026-09-23 · ♥12 · 9 题
- Agent 开发第一次面试:简历被挖了一遍 · 小红薯6A8D38D9 · 2026-09-10 · ♥453 · 12 题
- 字节跳动 Agent 研发工程师(基础设施)27 面经 · 孤飞 · 2026-09-17 · ♥67
- ai agent 面经:重心在 AI Coding 实践 · 三天逃课两天上网 · 2026-09-22 · ♥83
- 焦点科技 AI 应用研发一面 · Eversse · 2026-09-11 · ♥62
面试官视角与从业者判断:
- 一上午面试了六个 Agent 开发,全是半吊子 · 月亮向北 · 2026-09-15 · ♥760
- Agent 大佬的「焚决」:12 周上岸路线 · 芝士奶盖 · 2026-09-14 · ♥798
- agent 实习速成路线分享 · 大肥 · 2026-09-13 · ♥156(站内归档:把编程/后端基础排在 agent 基础之前)
- Agent 开发岗全是先进去再说的 · 一条小鱼🐟 · 2026-09-19 · ♥23
- 已入职者复盘:Agent 不是一个岗位,是一类岗位 · ppyy · 2026-09-17 · ♥29
- 关于 Agent 实习,感觉不用学那么多 · 刘三木 · 2026-09-16 · ♥682
外部题库:
- Agent Interview 100 · Leo 的 AI 产品进阶实操 · 2026-09-23 · ♥34
- 一个 agent 学习网站真的很清晰啊 · 星星海 · 2026-09-11 · ♥98
招聘侧佐证:腾讯混元基础模型团队 2026-09-23 发布「AI Agent Harness 工程实习生」, 要求里出现 Agent Loop / Tool Use / 隔离执行环境,未提任何框架名——见 9 月谁在招 Agent。
X 侧技术风向(不构成求职证据,只用于判断概念热度):
- AGENT HARNESSES ARE THE NEW GPT WRAPPERS · @gregisenberg · 2026-09-13 · ♥2495
- MCPs are better than CLIs for most integrations · @trq212 · 2026-09-15 · ♥3604
- DeepSeek Harness v0.1.5 · @tianyi · 2026-09-10 · ♥2004
这份清单会过期。11 场面试只覆盖 2026-09-10 到 09-23 这 14 天,题目全部是面试者自述、未经企业确认,寒武纪那场的三面尤其像「面试官想看看候选人怎么想」而不是标准答案。
但有一件事现在就能确定:这轮面试筛的不是知道最多名词的人,是能把 Agent 做成不失控系统的人。 剩下的距离,全在把「跑通过正常路径」变成「处理过失败路径」的那一侧。