寒武纪 AI Agent 开发 面经(三轮全记录,已 OC)
- 面试岗位:AI Agent 开发
- 面试时长:2h(三轮)
- 面试体验:★★★★★
- 结果:已 OC
- 简单做一下自我介绍,重点说说你的 AI Agent 相关项目经历和技术栈。
- 讲一个你落地过的、踩坑最多的 AI Agent 项目,不用堆砌技术名词,完整梳理清楚项目的核心执行链路、核心流程逻辑。
- 在业务产线的意图识别场景中,为什么不能单纯依赖大模型做分类?实际工程中,轻量模型和规则策略是如何搭配使用、协同落地的?
- 业务中遇到意图歧义、模型输出置信度低的场景,你们的兜底方案是什么?结合一个真实的线上 bad case 具体说明。
- 聊聊你的 RAG 分块策略,chunk 大小、重叠区间如何配置?实际场景中,你会如何选择语义分块、结构分块两种方式,依据是什么?
- RAG 检索流程中,粗排完成后为什么必须接入 cross-encoder 做重排?重排的候选数量如何界定、依据是什么?
- 对比传统 RAG,Agentic RAG 的核心差异是什么?Agent 在执行过程中,如何自主判断检索次数、如何动态改写检索 query?
- 讲讲 LangChain Chain 和 LangGraph 状态机的本质区别,为什么复杂的 Agent 业务场景,不适合用纯 Chain 架构实现?
- 在 LangGraph 框架中,State 状态、Node 节点、条件边三者如何配合,实现 Agent 的循环决策、分支判断逻辑?
- LangGraph 的 Checkpoint 断点恢复机制底层是怎么实现的?针对国产算力资源受限的场景,Agent 的状态数据应该存储在哪里最优?
- AI 代码助手场景中,如何将完整的代码仓库上下文高效输入模型?是全量灌入,还是采用分层检索的方案?说明你的选型逻辑。
- 你对 Claude Code、Codex 这类代码辅助模型的 harness 执行思路了解多少?项目中的 agent.md、skills 能力文件是如何落地使用的?
- 算法手撕:给定一段非结构化日志流,提取出其中的意图标签序列,完成去重保序处理(LeetCode316 变形题)。
- Redis 在 AI Agent 系统中主要承担哪些存储作用?对话历史如何做长度管控?如何设计架构,避免将全量对话历史输入模型造成资源浪费?
- 针对模型调用失败、工具调用超时、工具返回脏数据等异常场景,你的 Agent 循环逻辑如何做熔断、降级处理?
- 做一个针对性的自我介绍,侧重项目架构、工程落地和问题优化经历。
- 请你手绘一套企业级研发助手 Agent 的完整分层架构,详细讲解接入层、编排层、工具层、存储层、可观测层的核心能力与职责。
- 在 Agent 架构中,Planner 规划器和 Critic 校验器的分工是什么?Critic 如何精准识别模型幻觉、工具返回无效结果等问题?
- LangGraph 的状态序列化如何做版本兼容?如果图的定义发生变更,存量未结束的用户会话该如何迁移适配?
- Human-in-the-loop 人机交互机制,在 LangGraph 中具体如何实现?如果人工长时间无响应,系统如何做超时降级、容错处理?
- 多 Agent 协作有四种主流拓扑:Supervisor 监管式、群聊式、流水线式、层级式,请分别说明每种拓扑的适用业务场景和优缺点。
- 多 Agent 协作场景中,如何解决上下文爆炸的问题?Agent 之间交互是传递全量上下文,还是仅传递核心结论?说明工程选型依据。
- A2A 和 MCP 协议的核心区别是什么?为什么企业级 Agent 系统需要同时集成两套协议能力?
- Agent 工具调用场景中,如何做好参数校验,防范命令注入攻击?SSRF 漏洞在 Agent 系统中会如何暴露,对应的防护方案是什么?
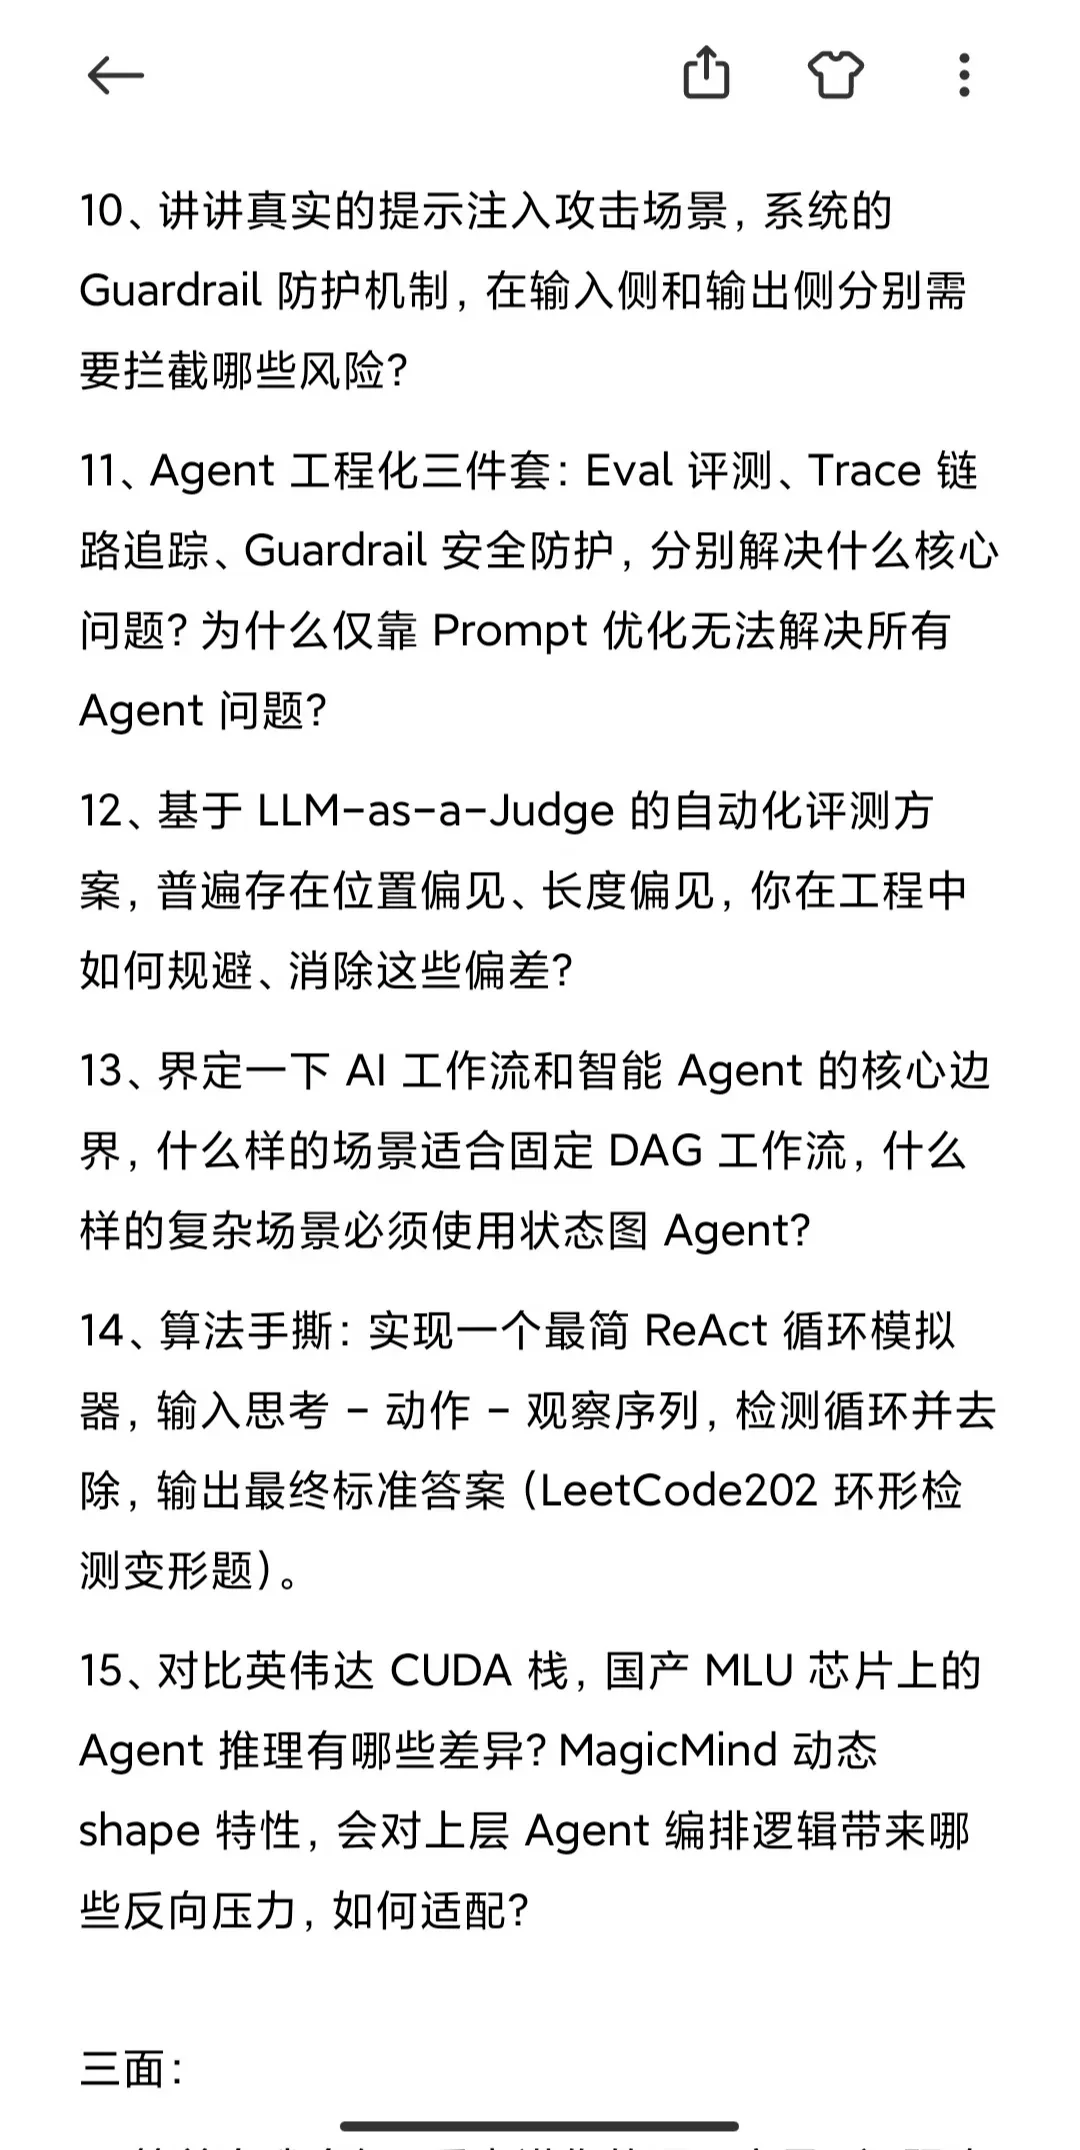
- 讲讲真实的提示注入攻击场景,系统的 Guardrail 防护机制,在输入侧和输出侧分别需要拦截哪些风险?
- Agent 工程化三件套:Eval 评测、Trace 链路追踪、Guardrail 安全防护,分别解决什么核心问题?为什么仅靠 Prompt 优化无法解决所有 Agent 问题?
- 基于 LLM-as-a-Judge 的自动化评测方案,普遍存在位置偏见、长度偏见,你在工程中如何规避、消除这些偏差?
- 界定一下 AI 工作流和智能 Agent 的核心边界,什么样的场景适合固定 DAG 工作流,什么样的复杂场景必须使用状态图 Agent?
- 算法手撕:实现一个最简 ReAct 循环模拟器,输入思考 - 动作 - 观察序列,检测循环并去除,输出最终标准答案(LeetCode202 环形检测变形题)。
- 对比英伟达 CUDA 栈,国产 MLU 芯片上的 Agent 推理有哪些差异?MagicMind 动态 shape 特性,会对上层 Agent 编排逻辑带来哪些反向压力,如何适配?
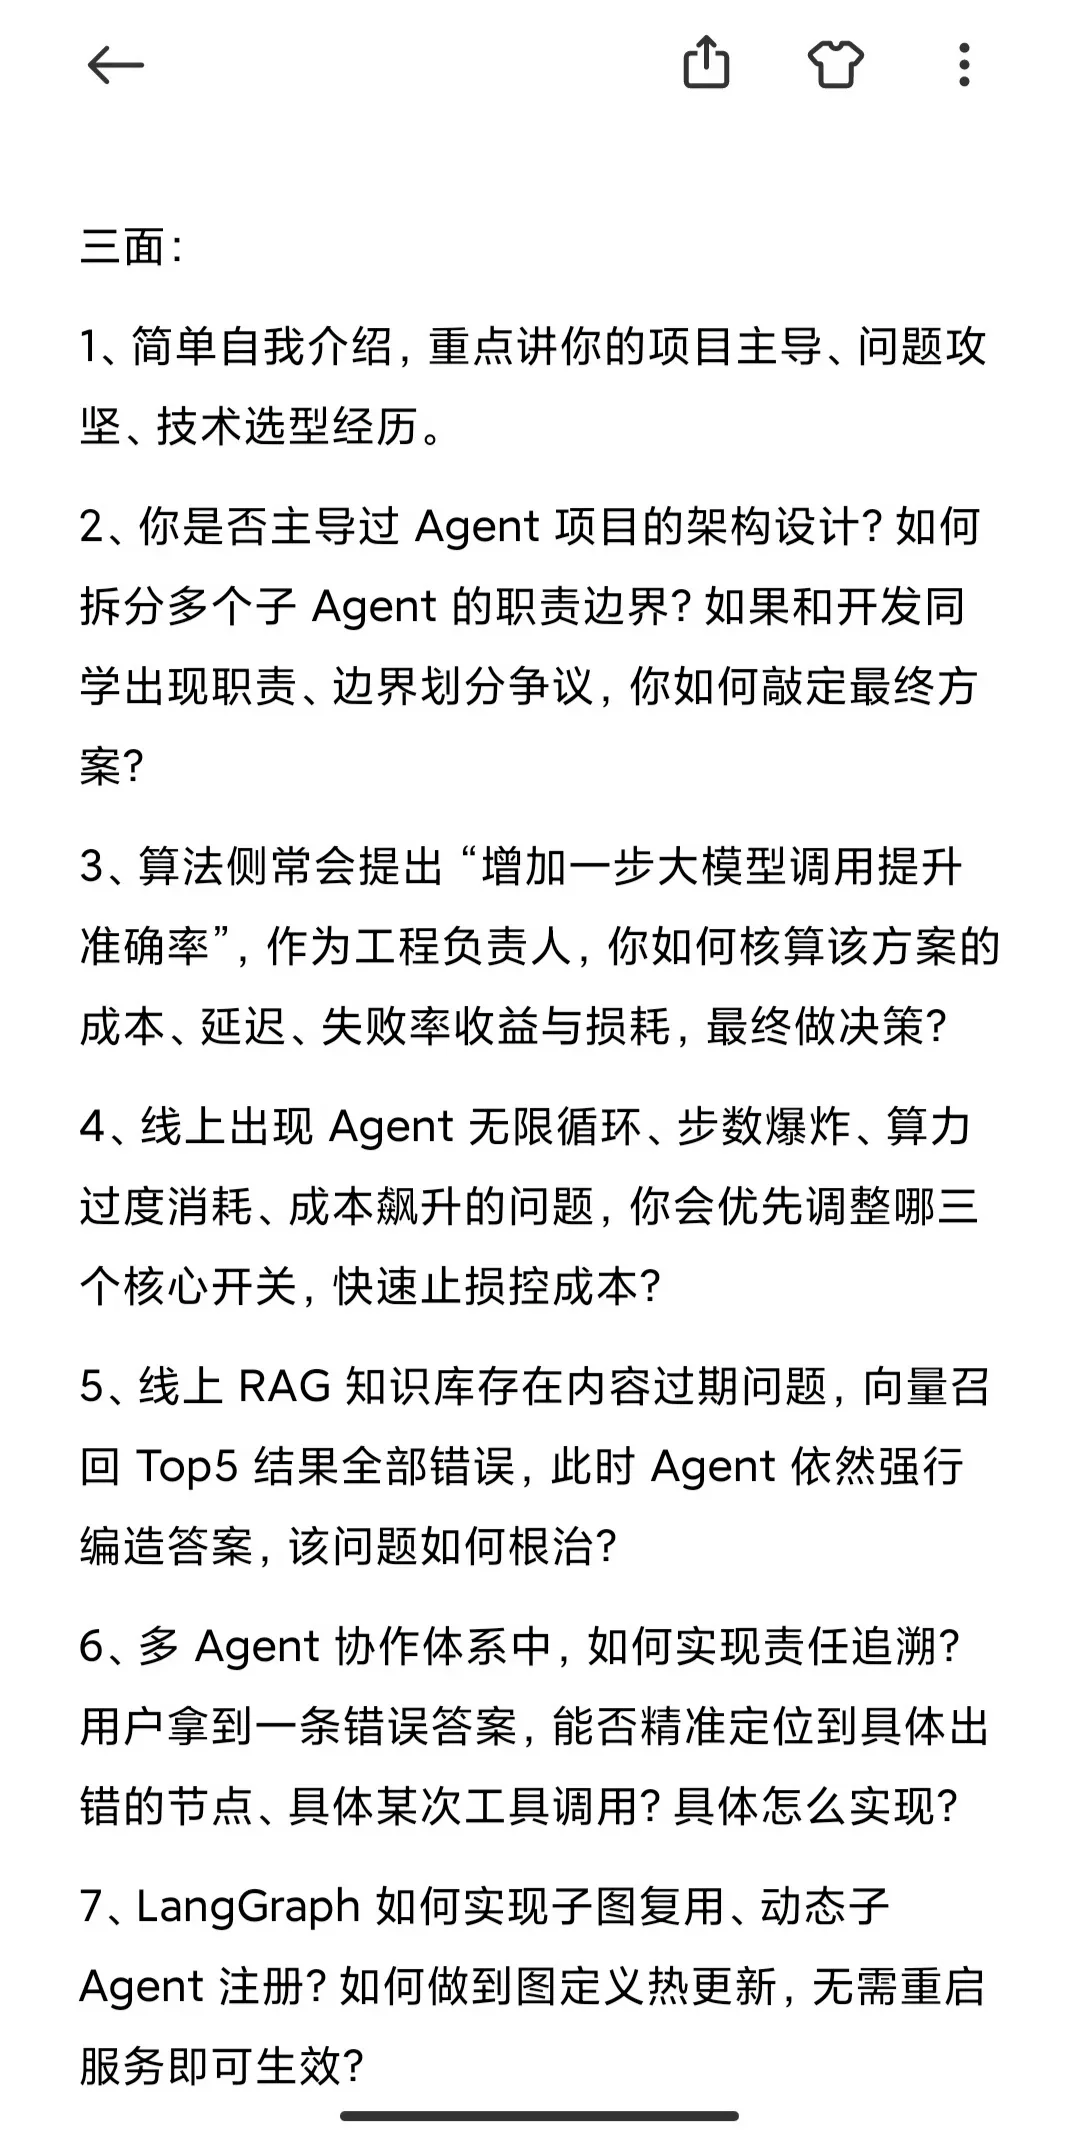
- 简单自我介绍,重点讲你的项目主导、问题攻坚、技术选型经历。
- 你是否主导过 Agent 项目的架构设计?如何拆分多个子 Agent 的职责边界?如果和开发同学出现职责、边界划分争议,你如何敲定最终方案?
- 算法侧常会提出"增加一步大模型调用提升准确率",作为工程负责人,你如何核算该方案的成本、延迟、失败率收益与损耗,最终做决策?
- 线上出现 Agent 无限循环、步数爆炸、算力过度消耗、成本飙升的问题,你会优先调整哪三个核心开关,快速止损控成本?
- 线上 RAG 知识库存在内容过期问题,向量召回 Top5 结果全部错误,此时 Agent 依然强行编造答案,该问题如何根治?
- 多 Agent 协作体系中,如何实现责任追溯?用户拿到一条错误答案,能否精准定位到具体出错的节点、具体某次工具调用?具体怎么实现?
- LangGraph 如何实现子图复用、动态子 Agent 注册?如何做到图定义热更新,无需重启服务即可生效?
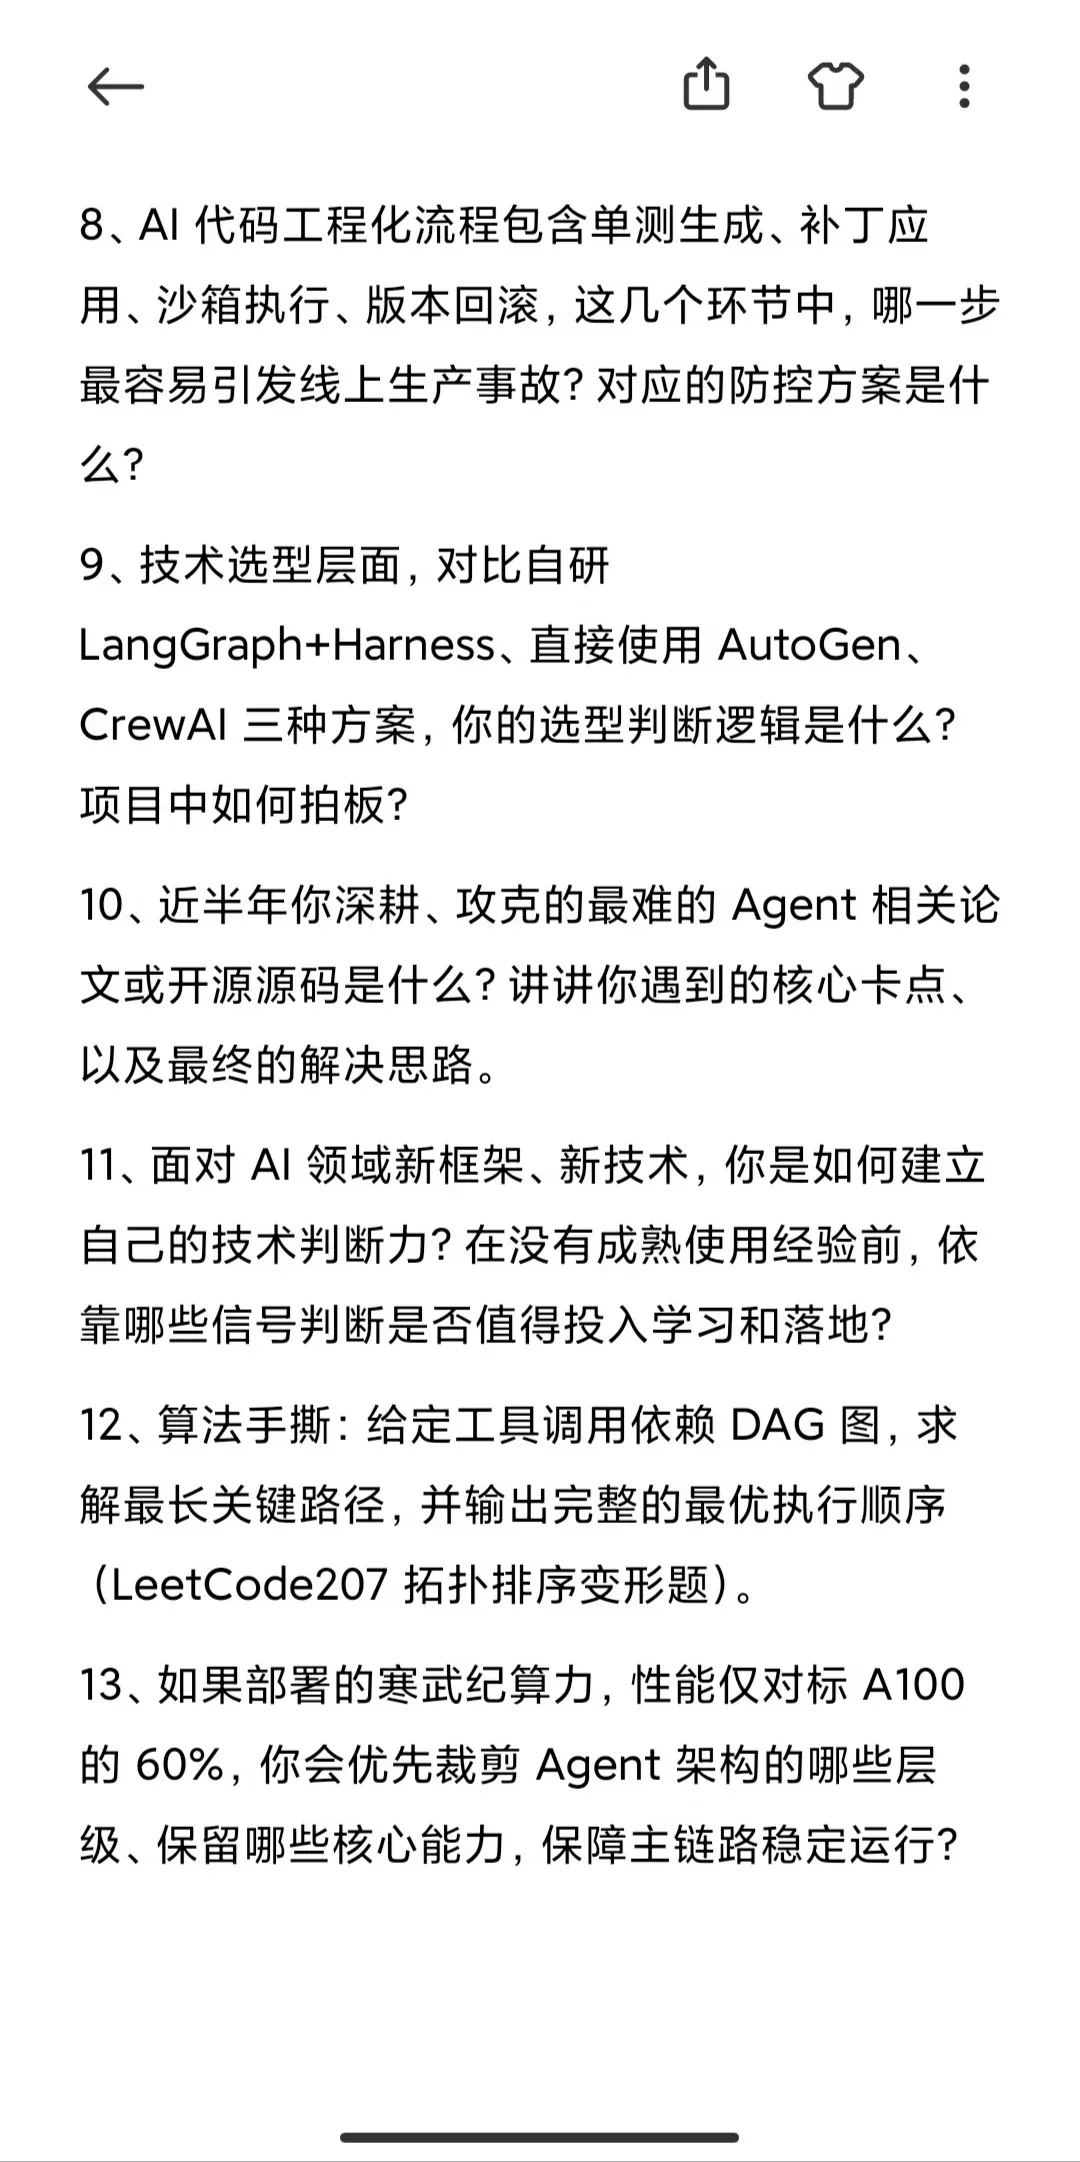
- AI 代码工程化流程包含单测生成、补丁应用、沙箱执行、版本回滚,这几个环节中,哪一步最容易引发线上生产事故?对应的防控方案是什么?
- 技术选型层面,对比自研 LangGraph+Harness、直接使用 AutoGen、CrewAI 三种方案,你的选型判断逻辑是什么?项目中如何拍板?
- 近半年你深耕、攻克的最难的 Agent 相关论文或开源源码是什么?讲讲你遇到的核心卡点、以及最终的解决思路。
- 面对 AI 领域新框架、新技术,你是如何建立自己的技术判断力?在没有成熟使用经验前,依靠哪些信号判断是否值得投入学习和落地?
- 算法手撕:给定工具调用依赖 DAG 图,求解最长关键路径,并输出完整的最优执行顺序(LeetCode207 拓扑排序变形题)。
- 如果部署的寒武纪算力,性能仅对标 A100 的 60%,你会优先裁剪 Agent 架构的哪些层级、保留哪些核心能力,保障主链路稳定运行?
这是本次调研里单场题目最多的一份(43 题,三轮),而且深度直逼 Agent Infra 岗:LangGraph Checkpoint 底层、State 序列化版本兼容、Human-in-the-loop 超时降级、A2A vs MCP、SSRF 与命令注入、LLM-as-a-Judge 的位置/长度偏见消除。
两条线索特别值得注意:
- 国产算力适配贯穿全场(Q10 状态存储、Q15 MLU/MagicMind 动态 shape、三面 Q13 算力仅 60% 时如何裁剪)——这是寒武纪区别于互联网大厂的考察重心。
- 三面全部是工程负责人视角:成本核算、止损开关、责任追溯、图热更新,考的是"能不能扛事",不是"会不会用框架"。